

Utilizzo di mmap
Il memory mapping (mmap) consente l'accesso diretto alla memoria per file di grandi dimensioni presenti su disco, permettendo a Milvus di memorizzare indici e dati sia in memoria che su disco rigido. Questo approccio contribuisce a ottimizzare la politica di collocazione dei dati in base alla frequenza di accesso, ampliando la capacità di archiviazione delle collezioni senza influire in modo significativo sulle prestazioni di ricerca. Questa pagina ti aiuta a comprendere come Milvus utilizza mmap per consentire l'archiviazione e il recupero dei dati in modo rapido ed efficiente.
Panoramica
Milvus utilizza le collezioni per organizzare le rappresentazioni vettoriali e i relativi metadati; ogni riga della collezione rappresenta un’entità. Come illustrato nella figura a sinistra qui sotto, il campo vettoriale memorizza le rappresentazioni vettoriali, mentre i campi scalari memorizzano i relativi metadati. Una volta creati gli indici su determinati campi e caricata la collezione, Milvus carica in memoria gli indici creati e i dati grezzi dei campi.
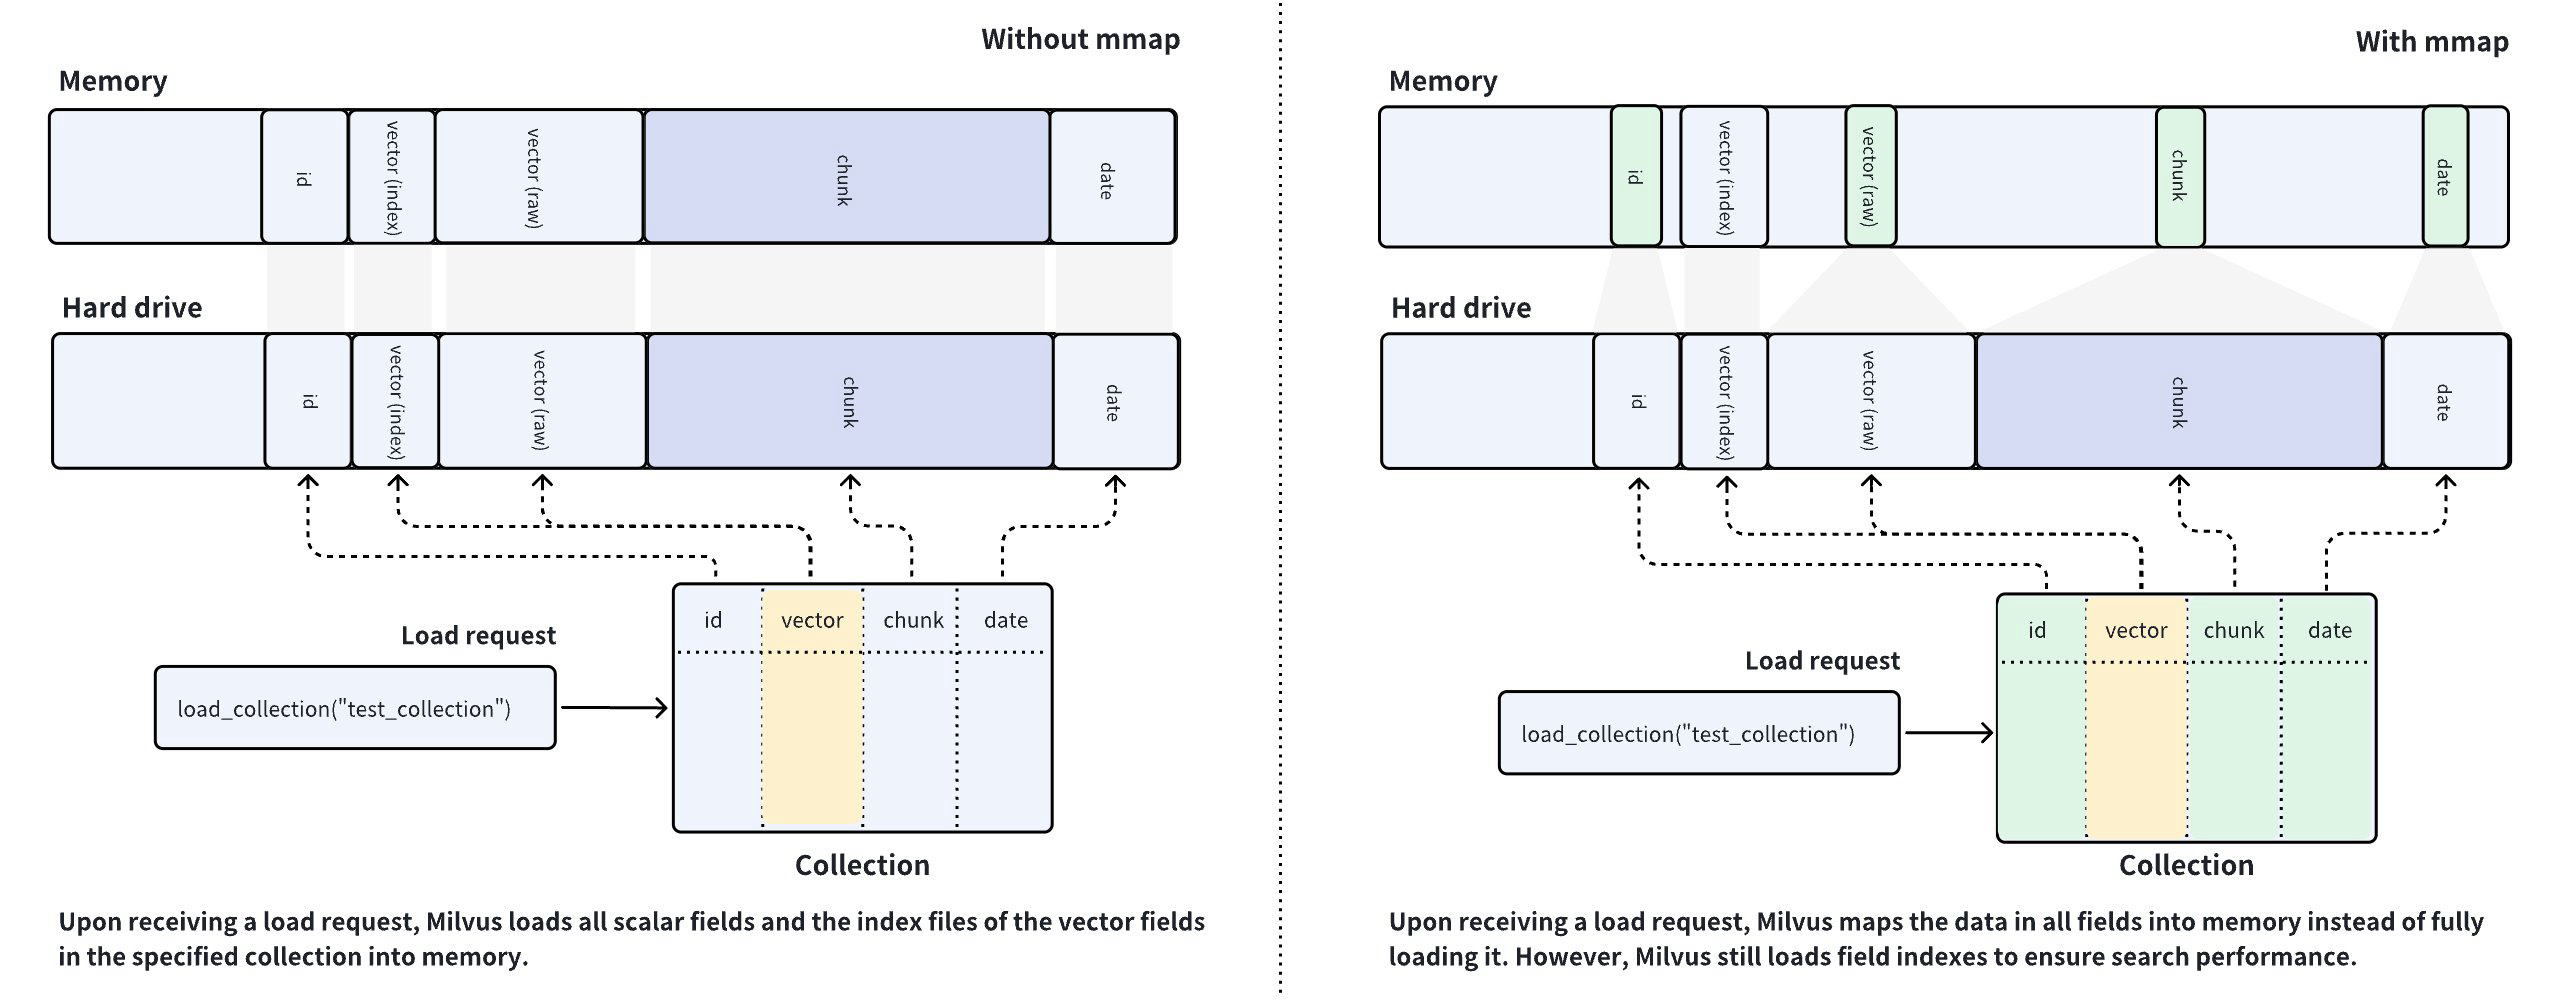 Mmap illustrato
Milvus è un sistema di database ad alto consumo di memoria e la dimensione della memoria disponibile determina la capacità di una collezione. Il caricamento in memoria di campi contenenti un grande volume di dati è impossibile se la dimensione dei dati supera la capacità della memoria, cosa che accade di solito nelle applicazioni basate sull’intelligenza artificiale.
Per risolvere tali problemi, Milvus introduce mmap per bilanciare il caricamento dei dati "caldi" e "freddi" nelle collezioni. Come mostrato nella figura a destra sopra, è possibile configurare Milvus in modo che esegua il memory-map dei dati grezzi in determinati campi invece di caricarli interamente in memoria. In questo modo, è possibile ottenere l’accesso diretto alla memoria per i campi senza preoccuparsi di problemi di memoria ed estendere la capacità della collezione.
Confrontando le procedure di collocazione dei dati nelle figure a sinistra e a destra, si può notare che l’utilizzo della memoria è molto più elevato nella figura a sinistra rispetto a quella a destra. Con mmap abilitato, i dati che avrebbero dovuto essere caricati in memoria vengono scaricati sul disco rigido e memorizzati nella cache delle pagine del sistema operativo, riducendo l’impronta di memoria. Tuttavia, gli errori di cache possono comportare un calo delle prestazioni. Per ulteriori dettagli, consultare questo articolo.
Quando si configura mmap su Milvus, è necessario attenersi sempre a un principio: mantenere sempre i dati e gli indici a cui si accede frequentemente completamente caricati in memoria e utilizzare mmap per quelli nei campi rimanenti.
Utilizzo di mmap in Milvus
Milvus offre impostazioni gerarchiche di mmap a livello globale, di campo, di indice e di raccolta, dove i livelli di indice e di campo hanno la precedenza su quello di raccolta, e quest’ultimo a sua volta su quello globale.
Impostazioni globali di mmap
L’impostazione a livello di cluster è quella globale e ha la priorità più bassa. Milvus offre diverse impostazioni relative a mmap in milvus.yaml. Queste impostazioni si applicano a tutte le collezioni del cluster.
...
queryNode:
  mmap:
    scalarField: false
    scalarIndex: false
    vectorField: false
    vectorIndex: false
    # The following should be a path on a high-performance disk
    mmapDirPath: any/valid/path
....
Configurazione elemento |
Descrizione |
Valore predefinito |
|---|---|---|
|
Specifica se mappare in memoria i dati grezzi di tutti i campi scalari. Impostando questo valore su |
|
|
Specifica se mappare in memoria tutti gli indici dei campi scalari. Impostando questo valore su Attualmente è supportato solo il campo scalare che utilizza il seguente tipo di indice:
|
|
|
Specifica se mappare in memoria i dati grezzi di tutti i campi vettoriali. Impostando questo parametro su ` |
|
|
Specifica se mappare tutti gli indici dei campi vettoriali in memoria. Impostando questo valore su " Attualmente sono supportati solo i campi vettoriali che utilizzano i seguenti tipi di indice:
|
|
|
Specifica il percorso dei file mappati in memoria. Se non specificato, viene applicato il valore predefinito. Il segnaposto " |
|
Per applicare le impostazioni di cui sopra al proprio cluster Milvus, seguire i passaggi descritti nelle sezioni Configurare Milvus con Helm e Configurare Milvus con Milvus Operators.
A volte, le impostazioni globali di mmap non sono sufficientemente flessibili per casi d’uso particolari. Per applicare impostazioni alternative a una collezione specifica o ai suoi indici, si consiglia di configurare mmap in modo specifico per una collezione, un campo o un indice. È necessario rilasciare e caricare una collezione prima che le modifiche alle impostazioni di mmap abbiano effetto.
Impostazioni mmap specifiche per campo
Per configurare mmap specifico per campo, è necessario includere il parametro ` mmap_enabled ` quando si aggiunge un campo. È possibile abilitare mmap su questo campo specifico impostando questo parametro su ` True`.
L’esempio seguente illustra come configurare l’mmap specifico per un campo al momento dell’aggiunta di un campo.
from pymilvus import MilvusClient, DataType

CLUSTER_ENDPOINT="http://localhost:19530"
TOKEN="root:Milvus"

client = MilvusClient(
    uri=CLUSTER_ENDPOINT,
    token=TOKEN
)

schema = MilvusClient.create_schema()
schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)
schema.add_field("vector", DataType.FLOAT_VECTOR, dim=5)

schema = MilvusClient.create_schema()

# Add a scalar field and enable mmap
schema.add_field(
    field_name="doc_chunk",
    datatype=DataType.INT64,
    is_primary=True,
    mmap_enabled=True,
)

# Alter mmap settings on a specific field
# The following assumes that you have a collection named `my_collection`
client.alter_collection_field(
    collection_name="my_collection",
    field_name="doc_chunk",
    field_params={"mmap.enabled": True}
)
import io.milvus.param.Constant;
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.*;

import java.util.*;

String CLUSTER_ENDPOINT = "http://localhost:19530";
String TOKEN = "root:Milvus";
client = new MilvusClientV2(ConnectConfig.builder()
        .uri(CLUSTER_ENDPOINT)
        .token(TOKEN)
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("vector")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());

Map<String, String> typeParams = new HashMap<String, String>() {{
    put(Constant.MMAP_ENABLED, "false");
}};
schema.addField(AddFieldReq.builder()
        .fieldName("doc_chunk")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .typeParams(typeParams)
        .build());

CreateCollectionReq req = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .build();
client.createCollection(req);

client.alterCollectionField(AlterCollectionFieldReq.builder()
        .collectionName("my_collection")
        .fieldName("doc_chunk")
        .property(Constant.MMAP_ENABLED, "true")
        .build());
import { MilvusClient, DataType } from '@zilliz/milvus2-sdk-node';

const CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT";
const TOKEN="YOUR_TOKEN";

const client = await MilvusClient({
    address: CLUSTER_ENDPOINT,
    token: TOKEN
});

const schema = [
{
    name: 'vector',
    data_type: DataType.FloatVector
},
{
    name: "doc_chunk",
    data_type: DataType.VarChar,
    max_length: 512,
    'mmap.enabled': false,
}
];

await client.createCollection({
    collection_name: "my_collection",
    schema: schema
});

await client.alterCollectionFieldProperties({
    collection_name: "my_collection",
    field_name: "doc_chunk",
    properties: {"mmap_enable": true}
});
// go
#restful
export TOKEN="root:Milvus"
export CLUSTER_ENDPOINT="http://localhost:19530"

export idField='{
    "fieldName": "id",
    "dataType": "Int64",
    "elementTypeParams": {
        "max_length": 512
    },
    "isPrimary": true,
    "autoId": false
}'

export vectorField='{
    "fieldName": "vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
       "dim": 5
    }
}'

export docChunkField='{
    "fieldName": "doc_chunk",
    "dataType": "Int64",
    "elementTypeParams": {
        "max_length": 512,
        "mmap.enabled": false
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $idField,
        $docChunkField,
        $vectorField
    ]
}"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema
}"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/fields/alter_properties" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "fieldName": "doc_chunk",
    "fieldParams":{
        "mmap.enabled": true
    }
}'
Si consiglia di abilitare mmap per i campi che memorizzano grandi volumi di dati. Sono supportati sia i campi scalari che quelli vettoriali.
Successivamente, è possibile creare una collezione utilizzando lo schema creato in precedenza. Alla ricezione di una richiesta di caricamento della collezione, Milvus mappa in memoria i dati grezzi del campo ` doc_chunk `.
Impostazioni mmap specifiche per l’indice
Per configurare il mmap specifico per l’indice, è necessario includere la proprietà ` mmap.enable ` nei parametri dell’indice al momento dell’aggiunta. È possibile abilitare il mmap su questo specifico indice impostando la proprietà su ` true`.
L’esempio seguente illustra come configurare il mmap specifico per l’indice al momento dell’aggiunta di un indice.
# Add a varchar field
schema.add_field(
    field_name="title",
    datatype=DataType.VARCHAR,
    max_length=512
)

index_params = MilvusClient.prepare_index_params()

# Create index on the varchar field with mmap settings
index_params.add_index(
    field_name="title",
    index_type="AUTOINDEX",
    params={ "mmap.enabled": "false" }
)

# Change mmap settings for an index
# The following assumes that you have a collection named `my_collection`
client.alter_index_properties(
    collection_name="my_collection",
    index_name="title",
    properties={"mmap.enabled": True}
)
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .build());

List<IndexParam> indexParams = new ArrayList<>();
Map<String, Object> extraParams = new HashMap<String, Object>() {{
    put(Constant.MMAP_ENABLED, false);
}};
indexParams.add(IndexParam.builder()
        .fieldName("title")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .extraParams(extraParams)
        .build());

client.alterIndexProperties(AlterIndexPropertiesReq.builder()
        .collectionName("my_collection")
        .indexName("title")
        .property(Constant.MMAP_ENABLED, "true")
        .build());
// Create index on the varchar field with mmap settings
await client.createIndex({
    collection_name: "my_collection",
    field_name: "title",
    params: { "mmap.enabled": false }
});

// Change mmap settings for an index
// The following assumes that you have a collection named `my_collection`
await client.alterIndexProperties({
    collection_name: "my_collection",
    index_name: "title",
    properties:{"mmap.enabled": true}
});
// go
# restful
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/indexes/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "indexParams": [
        {
            "fieldName": "doc_chunk",
            "params": {
                "index_type": "AUTOINDEX",
                "mmap.enabled": true
            }
        }
    ]
}'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/indexes/alter_properties" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "indexName": "doc_chunk",
    "properties": {
        "mmap.enabled": false
    }
}'
Ciò si applica agli indici sia dei campi vettoriali che di quelli scalari.
È quindi possibile fare riferimento ai parametri dell’indice in una collezione. Alla ricezione di una richiesta di caricamento della collezione, Milvus mappa in memoria l’indice del campo titolo.
Impostazioni mmap specifiche per la collezione
Per configurare una strategia mmap a livello di collezione, è necessario includere la proprietà ` mmap.enabled ` nella richiesta di creazione della collezione. È possibile abilitare mmap per una collezione impostando questa proprietà su ` true`.
L’esempio seguente illustra come abilitare mmap in una collezione denominata my_collection al momento della sua creazione. Quando riceve una richiesta di caricamento della collezione, Milvus mappa in memoria i dati grezzi di tutti i campi.
# Enable mmap when creating a collection
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    properties={ "mmap.enabled": "true" }
)
CreateCollectionReq req = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .property(Constant.MMAP_ENABLED, "false")
        .build();
client.createCollection(req);
await client.createCollection({
    collection_name: "my_collection",
    scheme: schema,
    properties: { "mmap.enabled": false }
});
// go
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"params\": {
        \"mmap.enabled\": \"false\"
    }
}"
È inoltre possibile modificare le impostazioni mmap di una collezione esistente.
# Release collection before change mmap settings
client.release_collection("my_collection")

# Ensure that the collection has already been released
# and run the following
client.alter_collection_properties(
    collection_name="my_collection",
    properties={
        "mmap.enabled": false
    }
)

# Load the collection to make the above change take effect
client.load_collection("my_collection")
client.releaseCollection(ReleaseCollectionReq.builder()
        .collectionName("my_collection")
        .build());

client.alterCollectionProperties(AlterCollectionPropertiesReq.builder()
        .collectionName("my_collection")
        .property(Constant.MMAP_ENABLED, "false")
        .build());

client.loadCollection(LoadCollectionReq.builder()
        .collectionName("my_collection")
        .build());
// Release collection before change mmap settings
await client.releaseCollection({
    collection_name: "my_collection"
});

// Ensure that the collection has already been released
// and run the following
await client.alterCollectionProperties({
    collection_name: "my_collection",
    properties: {
        "mmap.enabled": false
    }
});

// Load the collection to make the above change take effect
await client.loadCollection({
    collection_name: "my_collection"
});
// go
# restful
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/release" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection"
}'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/alter_properties" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "properties": {
        "mmmap.enabled": false
    }
}'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/load" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection"
}'
È necessario rilasciare la collezione per apportare modifiche alle sue proprietà e ricaricarla affinché le modifiche abbiano effetto.
