

Funzione MinHashCompatible with Milvus 3.0.x
La funzione MinHash converte il testo grezzo in vettori binari che approssimano la similarità di Jaccard tra i documenti. Applica lo shingling del testo e diverse funzioni hash per produrre vettori di firma a lunghezza fissa, consentendo un rilevamento rapido dei quasi-duplicati e la deduplicazione dei documenti su larga scala.
Essendo una funzione integrata, MinHash viene eseguita all’interno di Milvus e non richiede inferenza di modelli esterni né pre-elaborazione. È sufficiente inserire il testo grezzo e Milvus genera automaticamente i vettori di firma MinHash.
Limiti
Il campo di output deve essere un campo di vettori binari (
BINARY_VECTOR) con una dimensione che soddisfi la condizionedim % 32 == 0, poiché ogni firma MinHash è un valore hash a 32 bit.L’
dimdel campo vettoriale binario deve essere uguale a32 * num_hashes. Una discrepanza causa un errore.Quando si utilizza l’indice
MINHASH_LSHcon l’output della funzione MinHash,mh_element_bit_widthdeve essere impostato su32.
Come funziona MinHash
MinHash è una tecnica di hashing sensibile alla località che stima la similarità di Jaccard tra insiemi. In Milvus, la funzione MinHash segue questa pipeline: si fornisce il testo grezzo come input e Milvus produce un vettore binario come output, gestendo internamente tutte le fasi intermedie.
Il flusso di lavoro complessivo consiste in una pipeline condivisa di elaborazione del testo utilizzata sia per l’acquisizione dei documenti che per l’elaborazione delle query, seguita da operazioni specifiche per ciascuna fase relative all’archiviazione e al recupero.
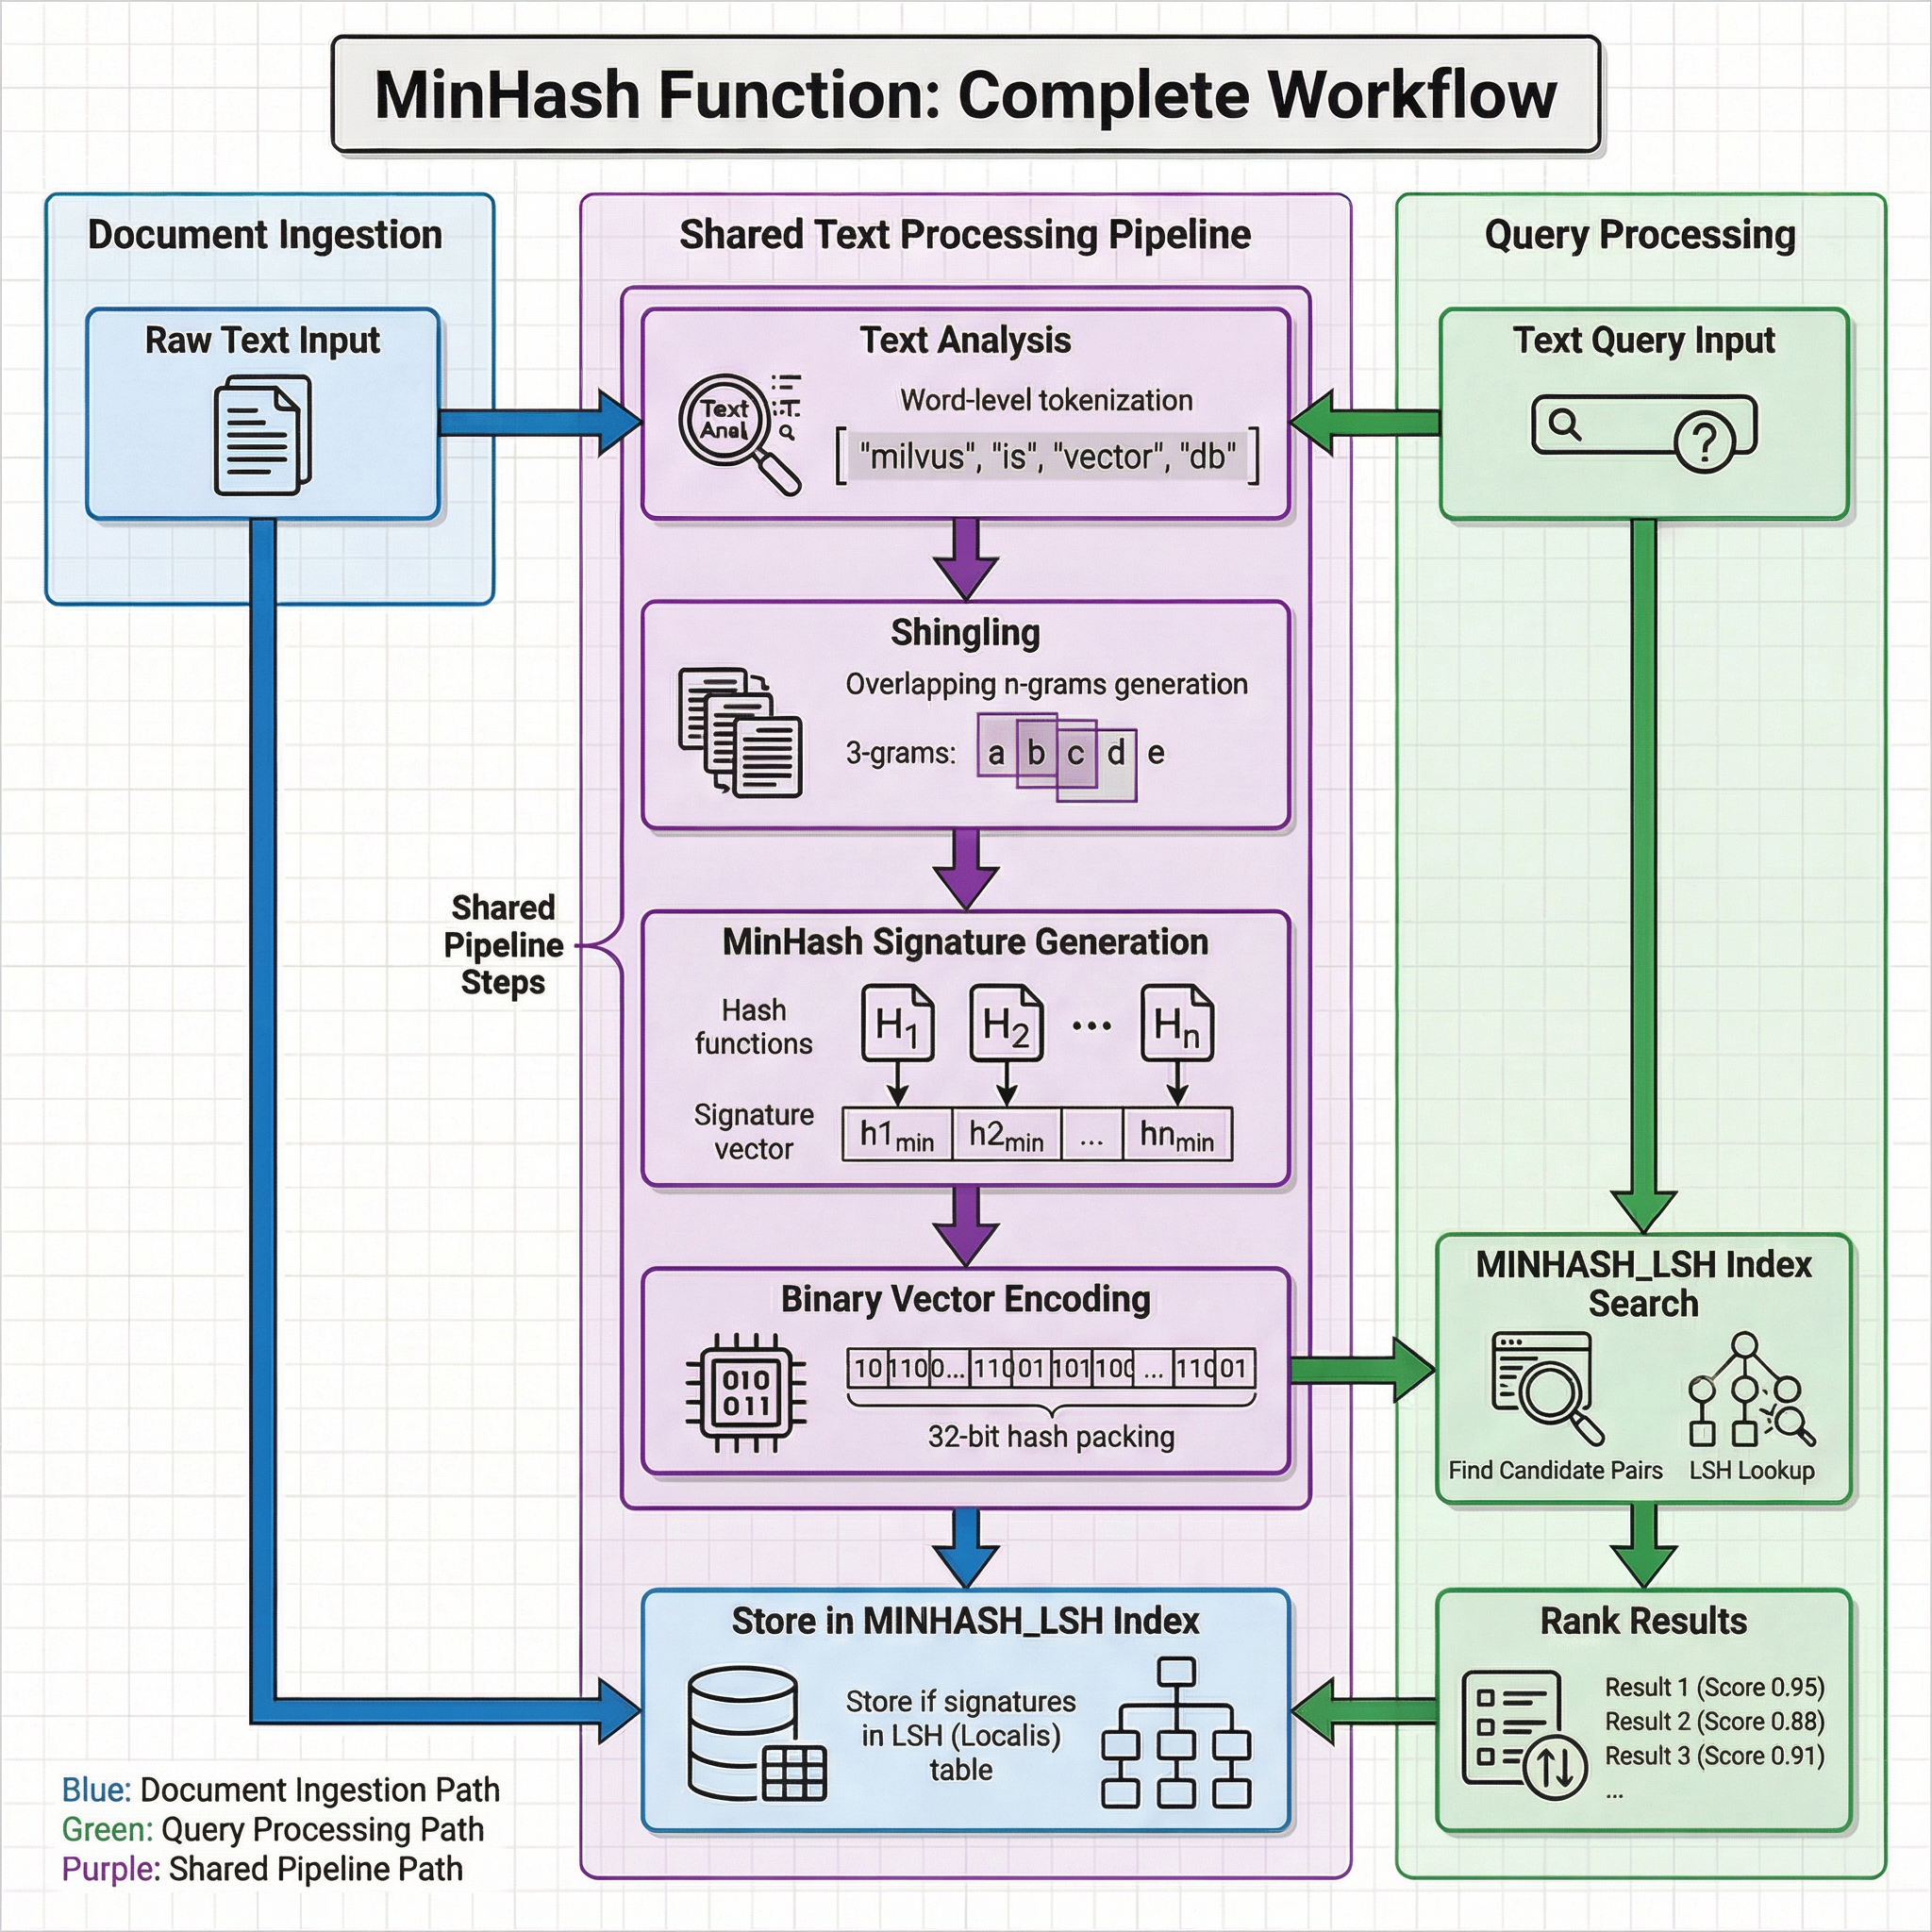 Iaqkbfeh8oqggsx6nsocfosondo
Pipeline condivisa di elaborazione del testo
Sia l’acquisizione dei documenti che l’elaborazione delle query sottopongono il testo grezzo alla stessa trasformazione in quattro fasi:
Analisi del testo: il testo viene elaborato da un analizzatore (quando
token_levelè"word") oppure utilizzato direttamente (quandotoken_levelè"char"). La tokenizzazione a livello di parola applica l’analizzatore configurato sul campo di input per segmentare il testo in termini — ad esempio,"milvus is vector db"diventa["milvus", "is", "vector", "db"].Shingling: i token vengono suddivisi in n-grammi sovrapposti (shingles) di dimensione
shingle_size. Ad esempio, con 3-grammi a livello di parola, i token["information", "retrieval", "is", "a", "field"]diventano shingles come["information retrieval is", "retrieval is a", "is a field"].Generazione della firma MinHash: all’insieme degli shingle vengono applicate più funzioni hash (H1, H2, …, Hn, dove n =
num_hashes). Per ciascuna funzione hash, viene selezionato il valore hash minimo tra tutti gli shingles. L’insieme di questi valori minimi costituisce la firma MinHash — una rappresentazione a lunghezza fissa che approssima la similarità di Jaccard del documento originale.Codifica a vettore binario: ogni valore della firma è un hash a 32 bit e la firma completa viene compressa in un
BINARY_VECTORdi dimensione32 * num_hashes.
Acquisizione dei documenti
Durante l’inserimento, il vettore binario prodotto dalla pipeline condivisa viene memorizzato nell’indice MINHASH_LSH. L’indice gestisce una tabella LSH (Locality-Sensitive Hashing) che raggruppa le firme simili negli stessi bucket, consentendo un rapido recupero dei candidati al momento della query.
Elaborazione delle query
Durante la ricerca, il testo della query passa attraverso la stessa pipeline condivisa per produrre un vettore binario. Questo vettore viene utilizzato per eseguire una ricerca LSH nell’indice MINHASH_LSH, che identifica rapidamente le coppie di candidati che potrebbero essere simili. Senza il raffinamento Jaccard, Milvus restituisce candidati LSH che non sono classificati in base alla somiglianza Jaccard stimata. Quando il raffinamento Jaccard è abilitato, Milvus utilizza le firme MinHash grezze memorizzate per classificare i candidati in base alla somiglianza Jaccard stimata e restituire i primi K risultati.
Poiché entrambi i percorsi condividono la stessa logica di trasformazione, due documenti con contenuti altamente sovrapposti producono firme MinHash simili. Ciò rende la funzione efficace per individuare quasi-duplicati anche quando i documenti differiscono per ordine delle parole, formattazione o piccole variazioni di formulazione.
Prima di iniziare
Prima di utilizzare la funzione MinHash, pianifica lo schema della tua raccolta in modo da includere quanto segue:
Un campo di testo per il contenuto grezzo
La raccolta deve includere un campo "
VARCHAR" per memorizzare il testo grezzo. Questo campo funge da input per la funzione MinHash.Un analizzatore per il campo di testo (quando si utilizza la tokenizzazione a livello di parola)
Se "
token_level" è impostato su ""word"" (impostazione predefinita), il campo di testo deve avere un analizzatore abilitato. L'analizzatore definisce come il testo viene tokenizzato prima dello shingling. Per impostazione predefinita, Milvus utilizza l'analizzatore "standard". Per configurare un analizzatore diverso, consultare la sezione "Scegliere l'analizzatore giusto per il proprio caso d'uso".Un campo vettore binario per l’output di MinHash
La collezione deve includere un campo di tipo "
BINARY_VECTOR" per memorizzare i vettori binari generati dalla funzione MinHash. La dimensione deve essere pari a "32 * num_hashes".
Passaggio 1: Creare una raccolta con una funzione MinHash
Per utilizzare la funzione MinHash, definirla al momento della creazione della raccolta. La funzione diventa parte dello schema della raccolta e viene applicata automaticamente durante l’inserimento e la ricerca dei dati.
Definire i campi dello schema
Lo schema della collezione deve includere almeno tre campi:
Campo primario: identifica in modo univoco ogni entità nella collezione.
Campo di testo (
VARCHAR): memorizza documenti di testo non elaborati. Impostare l'enable_analyzer=Truee in modo che Milvus possa elaborare il testo per la generazione della firma MinHash. Per impostazione predefinita, Milvus utilizza l'analizzatorestandardper l'analisi del testo. Per configurare un analizzatore diverso, consultare la sezione "Scegliere l'analizzatore giusto per il proprio caso d'uso".Campo vettori binari (
BINARY_VECTOR): memorizza i vettori binari generati automaticamente dalla funzione MinHash. La dimensione deve essere uguale a32 * num_hashes.
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(uri="http://localhost:19530", token="root:Milvus")

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)
schema.add_field(field_name="document_content", datatype=DataType.VARCHAR, max_length=9000, enable_analyzer=True)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=8192)
// java
// nodejs
// go
# restful
Definizione della funzione MinHash
La funzione MinHash converte il testo analizzato in vettori binari che approssimano la similarità di Jaccard tra i documenti.
Definisci la funzione e aggiungila al tuo schema:
minhash_function = Function(
    name="minhash_function",
    input_field_names=["document_content"], # Name of the VARCHAR field containing raw text
    output_field_names=["binary_vector"], # Name of the BINARY_VECTOR field for generated signatures
    function_type=FunctionType.MINHASH,
    params={
        "num_hashes": 256, # Number of hash functions; produces dim = 32 * 256 = 8192
        "shingle_size": 3, # N-gram size for shingling
    }
)

schema.add_function(minhash_function)
// java
// nodejs
// go
# restful
Opzioni di configurazione
Il dizionario ` params ` della funzione MinHash accetta i seguenti parametri. Tutti i nomi dei parametri non distinguono tra maiuscole e minuscole.
Parametro |
Tipo |
Valore predefinito |
Descrizione |
|---|---|---|---|
|
int |
Derivato da |
Numero di funzioni hash per la generazione della firma. La dimensione del vettore binario in uscita è pari a |
|
int |
|
Dimensione dell'N-gram per lo shingling. A livello di parola: tipicamente 1-3. A livello di carattere: tipicamente 2-6. |
|
str |
|
Funzione hash da utilizzare. Opzioni:
|
|
str |
|
Livello di tokenizzazione. Opzioni:
|
|
int |
|
Seme casuale per l’inizializzazione della funzione MinHash. |
Configurazione dell’indice
Il tipo di indice consigliato per i vettori binari MinHash è ` MINHASH_LSH`, con tipo di metrica ` MHJACCARD`.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_lsh_band": 128,
        "mh_element_bit_width": 32,
        "with_raw_data": True,
    },
)
// java
// nodejs
// go
# restful
Impostare with_raw_data su True se le ricerche utilizzeranno il raffinamento di Jaccard. Le firme MinHash grezze sono necessarie per calcolare la somiglianza di Jaccard stimata per i candidati restituiti dalla ricerca LSH.
Creare la collezione
Creare la collezione utilizzando lo schema e i parametri di indicizzazione definiti sopra:
client.create_collection(
    collection_name="dedup_collection",
    schema=schema,
    index_params=index_params,
)
// java
// nodejs
// go
# restful
Passaggio 2: Inserire i documenti
Dopo aver configurato la collezione, inserire i dati di testo. È sufficiente fornire il testo grezzo: la funzione MinHash genera automaticamente il vettore binario per ciascun documento.
client.insert(
    "dedup_collection",
    [
        {"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"},
        {"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"},
        {"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"},
    ],
)
// java
// nodejs
// go
# restful
Passaggio 3: Effettuare ricerche con MinHash
Una volta inseriti i dati, cerca i documenti quasi duplicati fornendo query di testo grezzo. Milvus converte automaticamente ogni query in un vettore binario MinHash. Abilita il raffinamento Jaccard per classificare i candidati LSH in base alla somiglianza Jaccard stimata.
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,
        "refine_k": 3,
    },
}

results = client.search(
    collection_name="dedup_collection",
    data=["information retrieval is a research field focused on helping users find relevant data in large collections"],
    anns_field="binary_vector",
    limit=3,
    output_fields=["document_content"],
    search_params=search_params,
)

for hits in results:
    for hit in hits:
        print(f"ID: {hit['id']}, Distance: {hit['distance']}")
        print(f"Document: {hit['entity']['document_content']}")
// java
// nodejs
// go
# restful
Impostare ` mh_search_with_jaccard ` su ` True ` per abilitare il raffinamento Jaccard. ` refine_k ` controlla la capacità del pool di candidati utilizzata per il raffinamento. Milvus utilizza ` max(refine_k, limit) ` come capacità, ma potrebbe raffinare un numero inferiore di candidati se la ricerca LSH restituisce meno corrispondenze. Aumentando ` refine_k ` è possibile migliorare la qualità dei risultati a costo di un maggiore carico di calcolo.
Prossimi passi
Ricerca full-text: utilizzare BM25 per il ranking di rilevanza lessicale invece che per il rilevamento di quasi-duplicati.
Panoramica sull’analizzatore: configurare analizzatori personalizzati per la tokenizzazione del testo.
Indice MINHASH_LSH: scopri come ottimizzare i parametri LSH per il recall e le prestazioni.
