

Gambaran Umum Model RankerCompatible with Milvus 2.6.x
Pencarian vektor tradisional mengurutkan hasil semata-mata berdasarkan kesamaan matematis—seberapa dekat vektor-vektor tersebut cocok dalam ruang berdimensi tinggi. Meskipun efisien, pendekatan ini sering kali melewatkan relevansi semantik yang sesungguhnya. Bayangkan Anda mencari “praktik terbaik untuk optimasi basis data”: Anda mungkin menerima dokumen dengan kesamaan vektor tinggi yang sering menyebut istilah-istilah tersebut, tetapi sebenarnya tidak memberikan strategi optimasi yang dapat diterapkan.
Model Ranker mengubah cara kerja pencarian Milvus dengan mengintegrasikan model bahasa canggih yang memahami hubungan semantik antara kueri dan dokumen. Alih-alih hanya mengandalkan kesamaan vektor, Model Ranker mengevaluasi makna dan konteks konten untuk memberikan hasil yang lebih cerdas dan relevan.
Batasan
Model Ranker tidak dapat digunakan dengan pencarian berkelompok.
Kolom yang digunakan untuk penataan ulang model harus berjenis teks (
VARCHAR).Setiap Model Ranker hanya dapat menggunakan satu bidang
VARCHARpada satu waktu untuk evaluasi.
Cara kerjanya
Model ranker mengintegrasikan kemampuan pemahaman model bahasa ke dalam proses pencarian Milvus melalui alur kerja yang terdefinisi dengan baik:
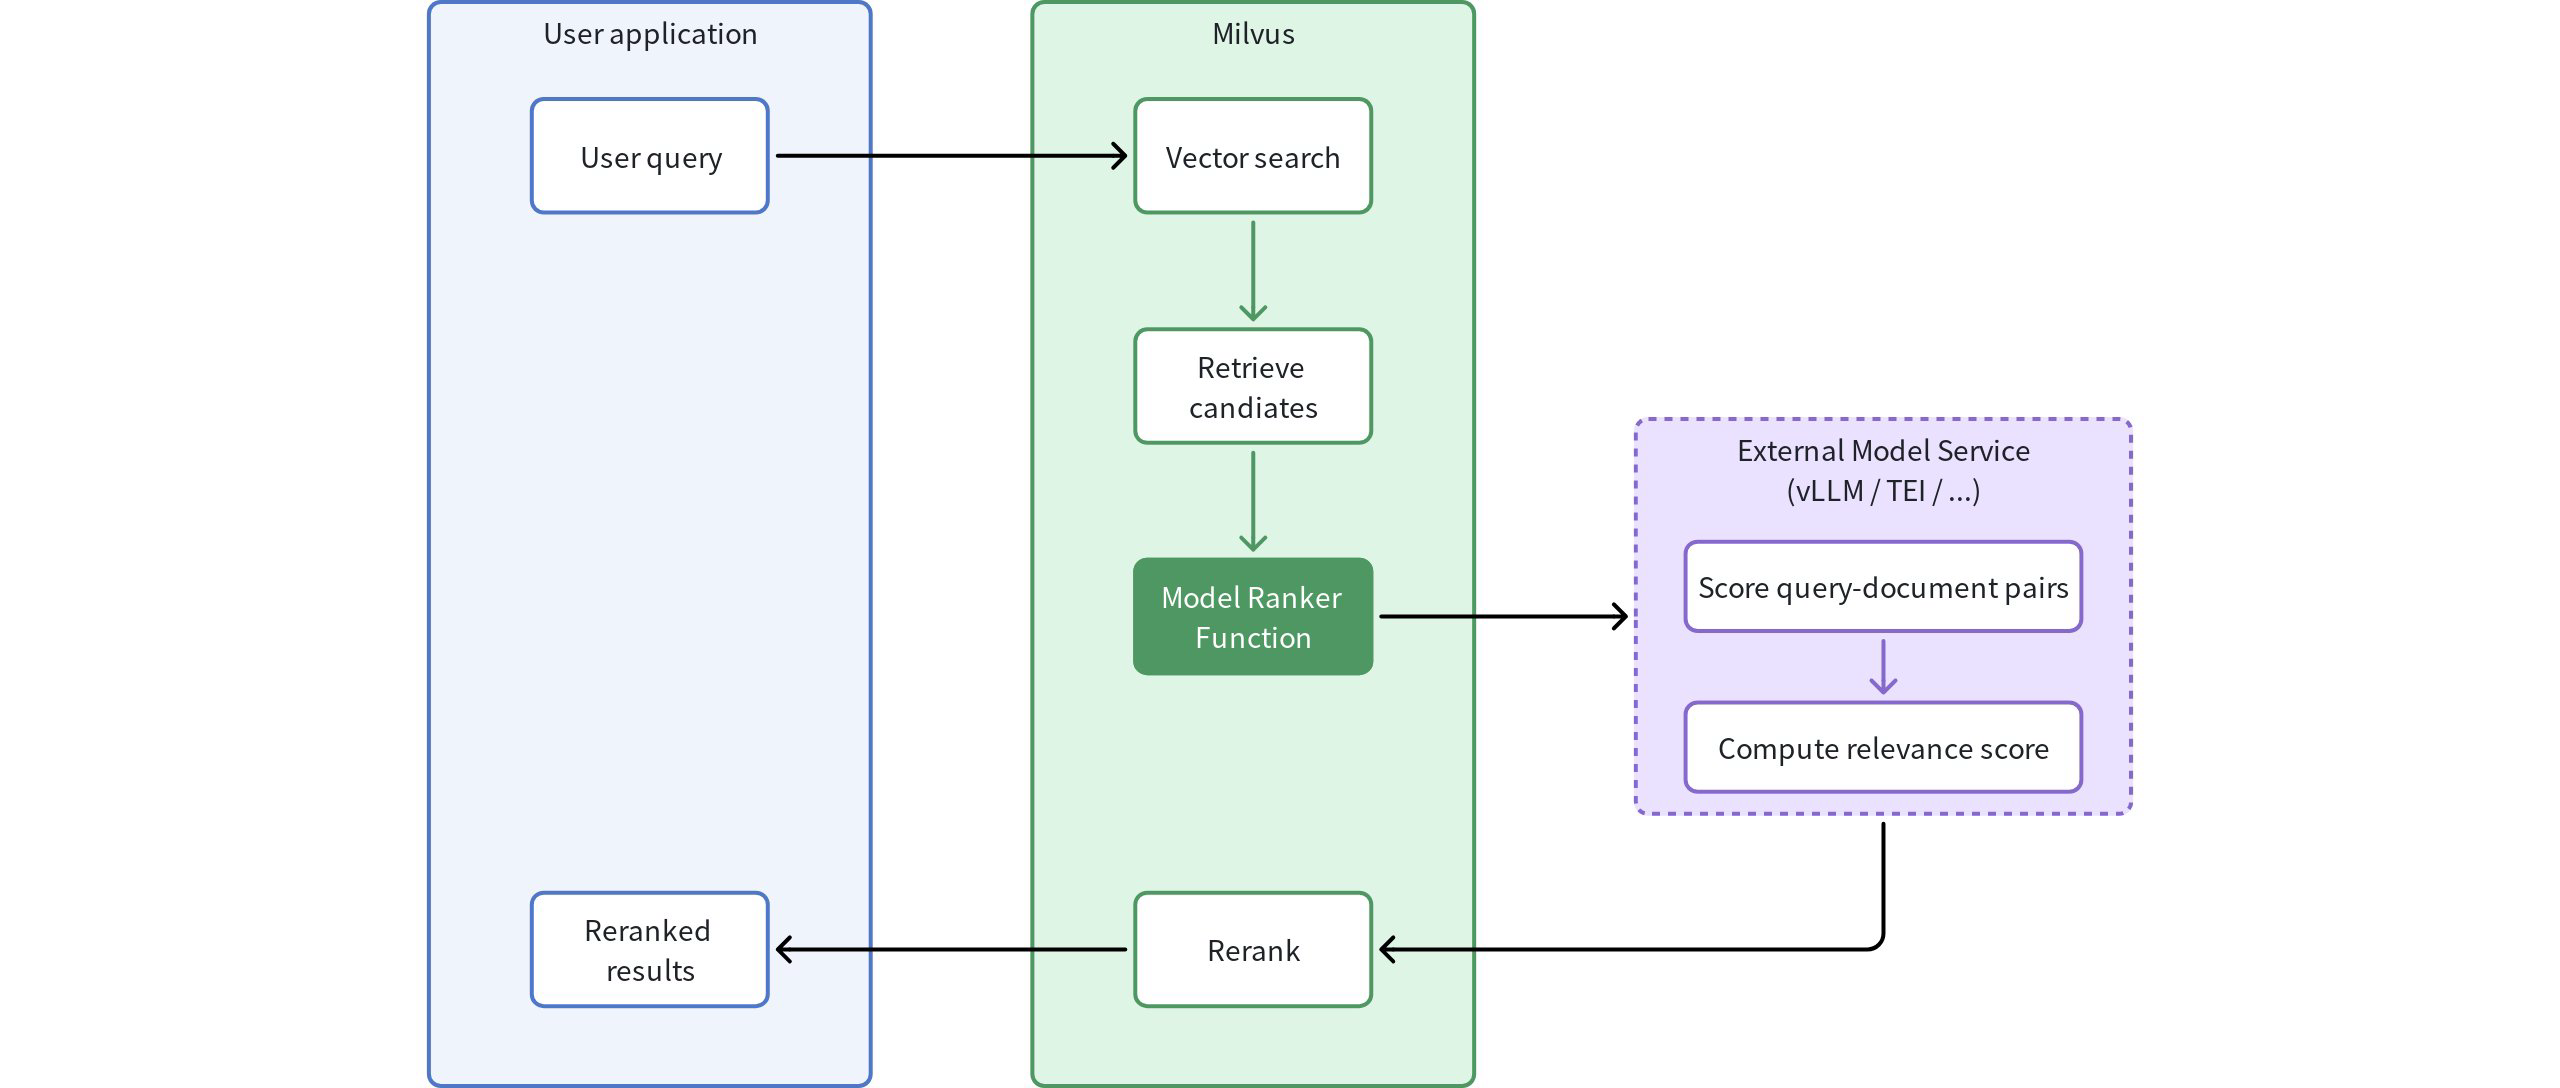 Gambaran Umum Model Ranker
Kueri awal: Aplikasi Anda mengirimkan kueri ke Milvus
Pencarian vektor: Milvus melakukan pencarian vektor standar untuk mengidentifikasi dokumen kandidat
Pengambilan kandidat: Sistem mengidentifikasi kumpulan awal dokumen kandidat berdasarkan kesamaan vektor
Evaluasi model: Fungsi Model Ranker memproses pasangan kueri-dokumen:
Mengirimkan kueri asli dan dokumen kandidat ke layanan model eksternal
Model bahasa mengevaluasi relevansi semantik antara kueri dan setiap dokumen
Setiap dokumen menerima skor relevansi berdasarkan pemahaman semantik
Penataan ulang yang cerdas: Dokumen-dokumen diurutkan ulang berdasarkan skor relevansi yang dihasilkan model
Hasil yang ditingkatkan: Aplikasi Anda menerima hasil yang diurutkan berdasarkan relevansi semantik, bukan hanya kesamaan vektor
Pilih penyedia model yang sesuai dengan kebutuhan Anda
Milvus mendukung penyedia layanan model berikut untuk pengurutan ulang, masing-masing dengan karakteristik yang berbeda:
Penyedia |
Cocok Untuk |
Karakteristik |
Contoh Kasus Penggunaan |
|---|---|---|---|
vLLM |
Aplikasi kompleks yang memerlukan pemahaman semantik mendalam dan penyesuaian |
|
Platform penelitian hukum yang menerapkan model khusus bidang yang memahami terminologi hukum dan hubungan yurisprudensi |
TEI |
Implementasi cepat dengan penggunaan sumber daya yang efisien |
|
Sistem manajemen konten yang membutuhkan kemampuan pengurutan ulang yang efisien dengan persyaratan standar |
Cohere |
Aplikasi perusahaan yang mengutamakan keandalan dan kemudahan integrasi |
|
Platform e-commerce yang membutuhkan pencarian dengan ketersediaan tinggi, kinerja API yang konsisten, dan katalog produk multibahasa |
Voyage AI |
Aplikasi RAG dengan persyaratan kinerja dan konteks tertentu |
|
Basis data penelitian dengan panjang dokumen yang bervariasi yang memerlukan kontrol kinerja yang disesuaikan secara halus dan pemahaman semantik khusus |
SiliconFlow |
Aplikasi yang memproses dokumen panjang dengan prioritas efisiensi biaya |
|
Sistem pencarian dokumentasi teknis yang memproses manual dan makalah panjang yang memerlukan segmentasi cerdas dan kontrol tumpang tindih |
Hugging Face |
Aplikasi yang menggunakan model kesamaan kalimat Hugging Face yang dihosting |
|
Aplikasi pencarian semantik yang ingin menyusun ulang urutan teks kandidat menggunakan model Hugging Face tanpa perlu mengoperasikan layanan inferensi terpisah |
Untuk informasi terperinci mengenai implementasi setiap layanan model, lihat dokumentasi khusus:
Penerapan
Sebelum mengimplementasikan Model Ranker, pastikan Anda memiliki:
Koleksi Milvus dengan bidang `
VARCHAR` yang berisi teks yang akan diurutkan ulangLayanan model eksternal yang sedang berjalan dan dapat diakses oleh instance Milvus Anda
Konektivitas jaringan yang memadai antara Milvus dan layanan model yang Anda pilih
Model ranker terintegrasi dengan mulus baik dengan operasi pencarian vektor standar maupun operasi pencarian hibrida. Implementasinya melibatkan pembuatan objek Function yang mendefinisikan konfigurasi pengurutan ulang Anda dan meneruskannya ke operasi pencarian.
Membuat model ranker
Untuk mengimplementasikan penentuan peringkat ulang model, pertama-tama tentukan objek Function dengan konfigurasi yang sesuai. Dalam contoh ini, kami menggunakan TEI sebagai penyedia layanan:
from pymilvus import MilvusClient, Function, FunctionType

# Connect to your Milvus server
client = MilvusClient(
    uri="http://localhost:19530"  # Replace with your Milvus server URI
)

# Create a model ranker function
model_ranker = Function(
    name="semantic_ranker",  # Function identifier
    input_field_names=["document"],  # VARCHAR field to use for reranking
    function_type=FunctionType.RERANK,  # Must be set to RERANK
    params={
        "reranker": "model",  # Specify model reranker. Must be "model"
        "provider": "tei",  # Choose provider: "tei", "vllm", etc.
        "queries": ["machine learning for time series"],  # Query text
        "endpoint": "http://model-service:8080",  # Model service endpoint
        # "maxBatch": 32  # Optional: batch size for processing
    }
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.ranker.ModelRanker;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

ModelRanker ranker = ModelRanker.builder()
        .name("semantic_ranker")
        .inputFieldNames(Collections.singletonList("document"))
        .provider("tei")
        .queries(Collections.singletonList("machine learning for time series"))
        .endpoint("http://model-service:8080")
        .build();
// nodejs
// go
# restful
Parameter |
Wajib? |
Deskripsi |
Nilai / Contoh |
|---|---|---|---|
|
Ya |
Pengidentifikasi untuk fungsi Anda yang digunakan saat melakukan pencarian. |
|
|
Ya |
Nama bidang teks yang akan digunakan untuk penentuan peringkat ulang. Harus berupa bidang bertipe " |
|
|
Ya |
Menentukan jenis fungsi yang sedang dibuat. Harus diatur ke " |
|
|
Ya |
Sebuah kamus yang berisi konfigurasi untuk fungsi pengurutan ulang berbasis model. Parameter (kunci) yang tersedia bervariasi tergantung pada penyedia layanan. |
|
|
Ya |
Harus disetel ke ` |
|
|
Ya |
Penyedia layanan model yang akan digunakan untuk pengurutan ulang. |
|
|
Ya |
Daftar string kueri yang digunakan oleh model penentuan peringkat ulang untuk menghitung skor relevansi. Jumlah string kueri harus sama persis dengan jumlah kueri dalam operasi pencarian Anda (bahkan saat menggunakan vektor kueri alih-alih teks), jika tidak, akan dilaporkan adanya kesalahan. |
|
|
Ya |
URL layanan model. |
|
|
Tidak |
Jumlah maksimum dokumen yang akan diproses dalam satu batch. Nilai yang lebih besar akan meningkatkan throughput tetapi membutuhkan lebih banyak memori. |
|
Terapkan ke pencarian vektor standar
Setelah mendefinisikan model ranker Anda, Anda dapat menggunakannya selama operasi pencarian dengan meneruskannya ke parameter ranker:
# Use the model ranker in standard vector search
results = client.search(
    collection_name,
    data=[your_query_vector], # Number of query vectors must match that specified in model_ranker.params["queries"]
    anns_field="vector_field",
    limit=10,
    output_fields=["document"],  # Include the text field in outputs
    ranker=model_ranker,  # Apply the model ranker here
    consistency_level="Bounded"
)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

SearchReq searchReq = SearchReq.builder()
        .collectionName(COLLECTION_NAME)
        .data(Collections.singletonList(new EmbeddedText("machine learning for time series")))
        .annsField("vector_field")
        .limit(10)
        .outputFields(Collections.singletonList(document))
        .functionScore(FunctionScore.builder()
                .addFunction(ranker)
                .build())
        .consistencyLevel(ConsistencyLevel.BOUNDED)
        .build();
SearchResp searchResp = client.search(searchReq);
// nodejs
// go
# restful
