

Gambaran Umum Fungsi EmbeddingCompatible with Milvus 2.6.x
Modul Fungsi di Milvus memungkinkan Anda mengubah data teks mentah menjadi embedding vektor dengan secara otomatis memanggil penyedia layanan embedding eksternal (seperti OpenAI, AWS Bedrock, Google Vertex AI, dll.). Dengan modul Fungsi, Anda tidak perlu lagi berinteraksi secara manual dengan API embedding—Milvus menangani seluruh proses pengiriman permintaan ke penyedia layanan, penerimaan embedding, dan penyimpanannya di koleksi Anda. Untuk pencarian semantik, Anda hanya perlu menyediakan data kueri mentah, bukan vektor kueri. Milvus menghasilkan vektor kueri dengan model yang sama yang Anda gunakan untuk pengambilan data, membandingkannya dengan vektor yang tersimpan, dan mengembalikan hasil yang paling relevan.
Batasan
Setiap bidang input yang di-embed oleh modul Function harus selalu berisi nilai; jika nilai null diberikan, modul akan memunculkan kesalahan.
Modul Function hanya memproses bidang yang secara eksplisit didefinisikan dalam skema koleksi; modul ini tidak menghasilkan embedding untuk bidang dinamis.
Bidang masukan yang akan di-embed harus bertipe "
VARCHAR".Modul Fungsi dapat menyematkan bidang masukan ke:
FLOAT_VECTORINT8_VECTOR
Konversi ke
BINARY_VECTOR,FLOAT16_VECTOR, atauBFLOAT16_VECTORtidak didukung.
Penyedia layanan penyisipan yang didukung
Penyedia |
Model Umum |
Jenis Penyisipan |
Metode Otentikasi |
|---|---|---|---|
text-embedding-3-* |
|
Kunci API |
|
Berbasis penerapan |
|
Kunci API |
|
text-embedding-v3 |
|
Kunci API |
|
amazon.titan-embed-text-v2 |
|
Pasangan AK/SK |
|
text-embedding-005 |
|
Kredensial JSON akun layanan GCP |
|
voyage-3, voyage-lite-02 |
|
Kunci API |
|
embed-english-v3.0 |
|
Kunci API |
|
BAAI/bge-large-zh-v1.5 |
|
Kunci API |
|
Model apa pun yang disajikan melalui TEI |
|
Kunci API opsional |
|
Model yang disajikan melalui |
|
Kunci API |
Cara kerjanya
Diagram berikut menunjukkan cara kerja Fungsi di Milvus.
Teks masukan: Pengguna memasukkan data mentah (misalnya dokumen) ke dalam Milvus.
Menghasilkan embedding: Modul Fungsi di dalam Milvus secara otomatis memanggil penyedia model yang telah dikonfigurasi untuk mengubah data mentah menjadi embedding vektor.
Menyimpan embedding: Embedding yang dihasilkan disimpan dalam bidang vektor yang didefinisikan secara eksplisit di dalam koleksi Milvus.
Kueri teks: Pengguna mengirimkan kueri teks ke Milvus.
Pencarian semantik: Milvus secara internal mengubah kueri menjadi embedding vektor, melakukan pencarian kesamaan terhadap embedding yang disimpan, dan mengambil hasil yang relevan.
Mengembalikan hasil: Milvus mengembalikan hasil yang paling sesuai ke aplikasi.
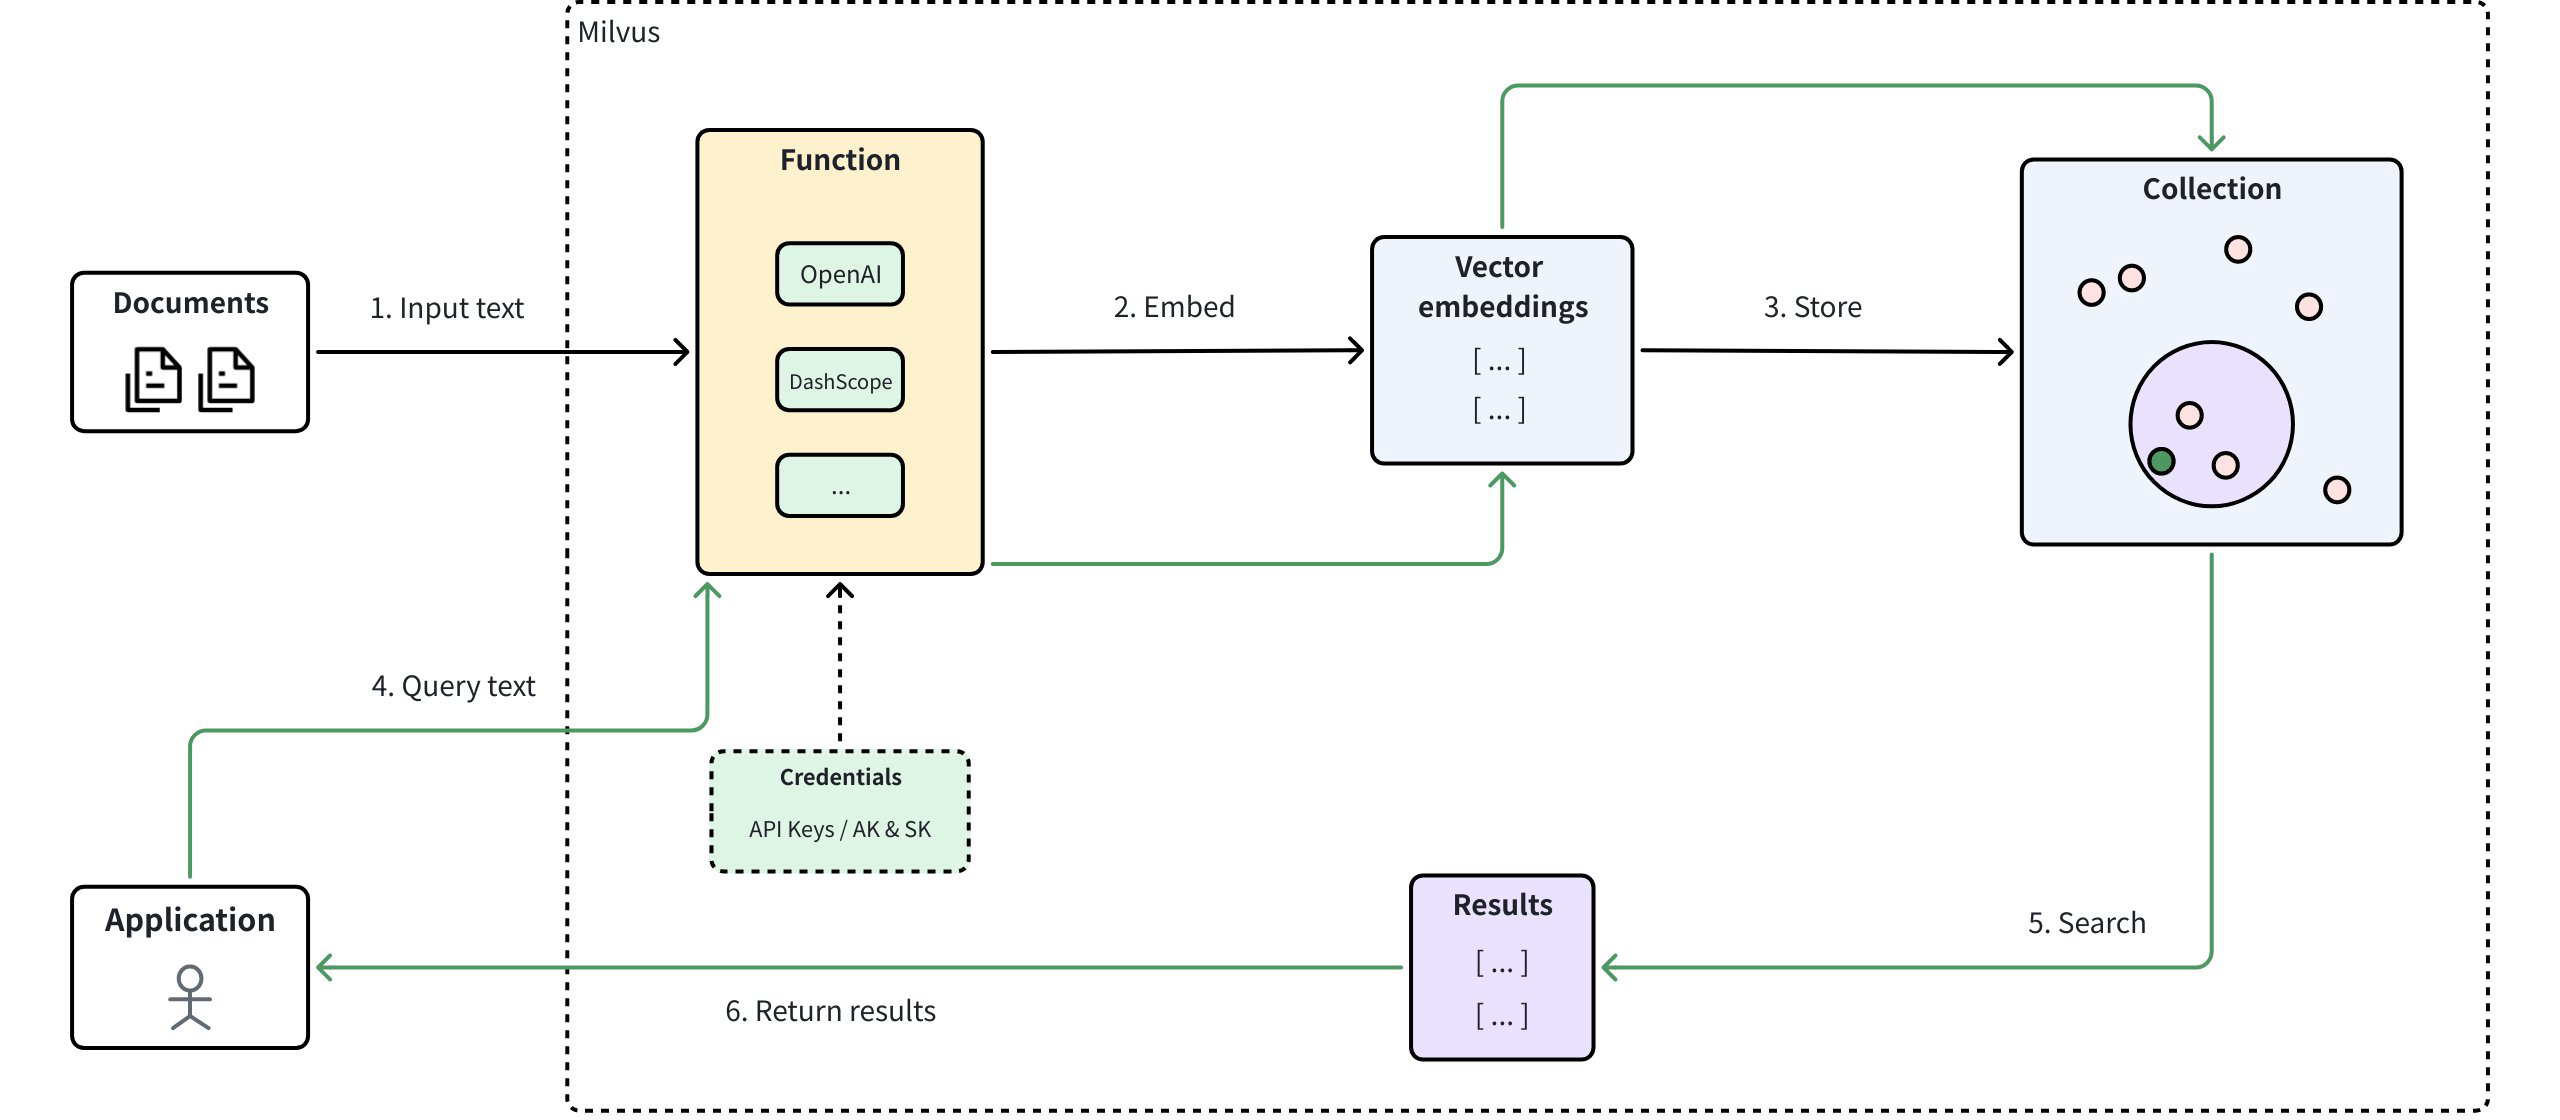 Ikhtisar Fungsi Embedding
Konfigurasi kredensial
Sebelum menggunakan fungsi embedding dengan Milvus, konfigurasikan kredensial layanan embedding untuk akses Milvus.
Milvus memungkinkan Anda memasukkan kredensial layanan embedding dengan dua cara:
Berkas konfigurasi (
milvus.yaml):Contoh dalam topik ini menunjukkan pengaturan yang direkomendasikan menggunakan
milvus.yaml.Variabel lingkungan:
Untuk detail tentang mengonfigurasi kredensial melalui variabel lingkungan, lihat dokumentasi penyedia layanan embedding (misalnya, OpenAI atau Azure OpenAI).
Diagram berikut menunjukkan proses konfigurasi kredensial melalui berkas konfigurasi Milvus (milvus.yaml) dan kemudian memanggil Fungsi di dalam Milvus.
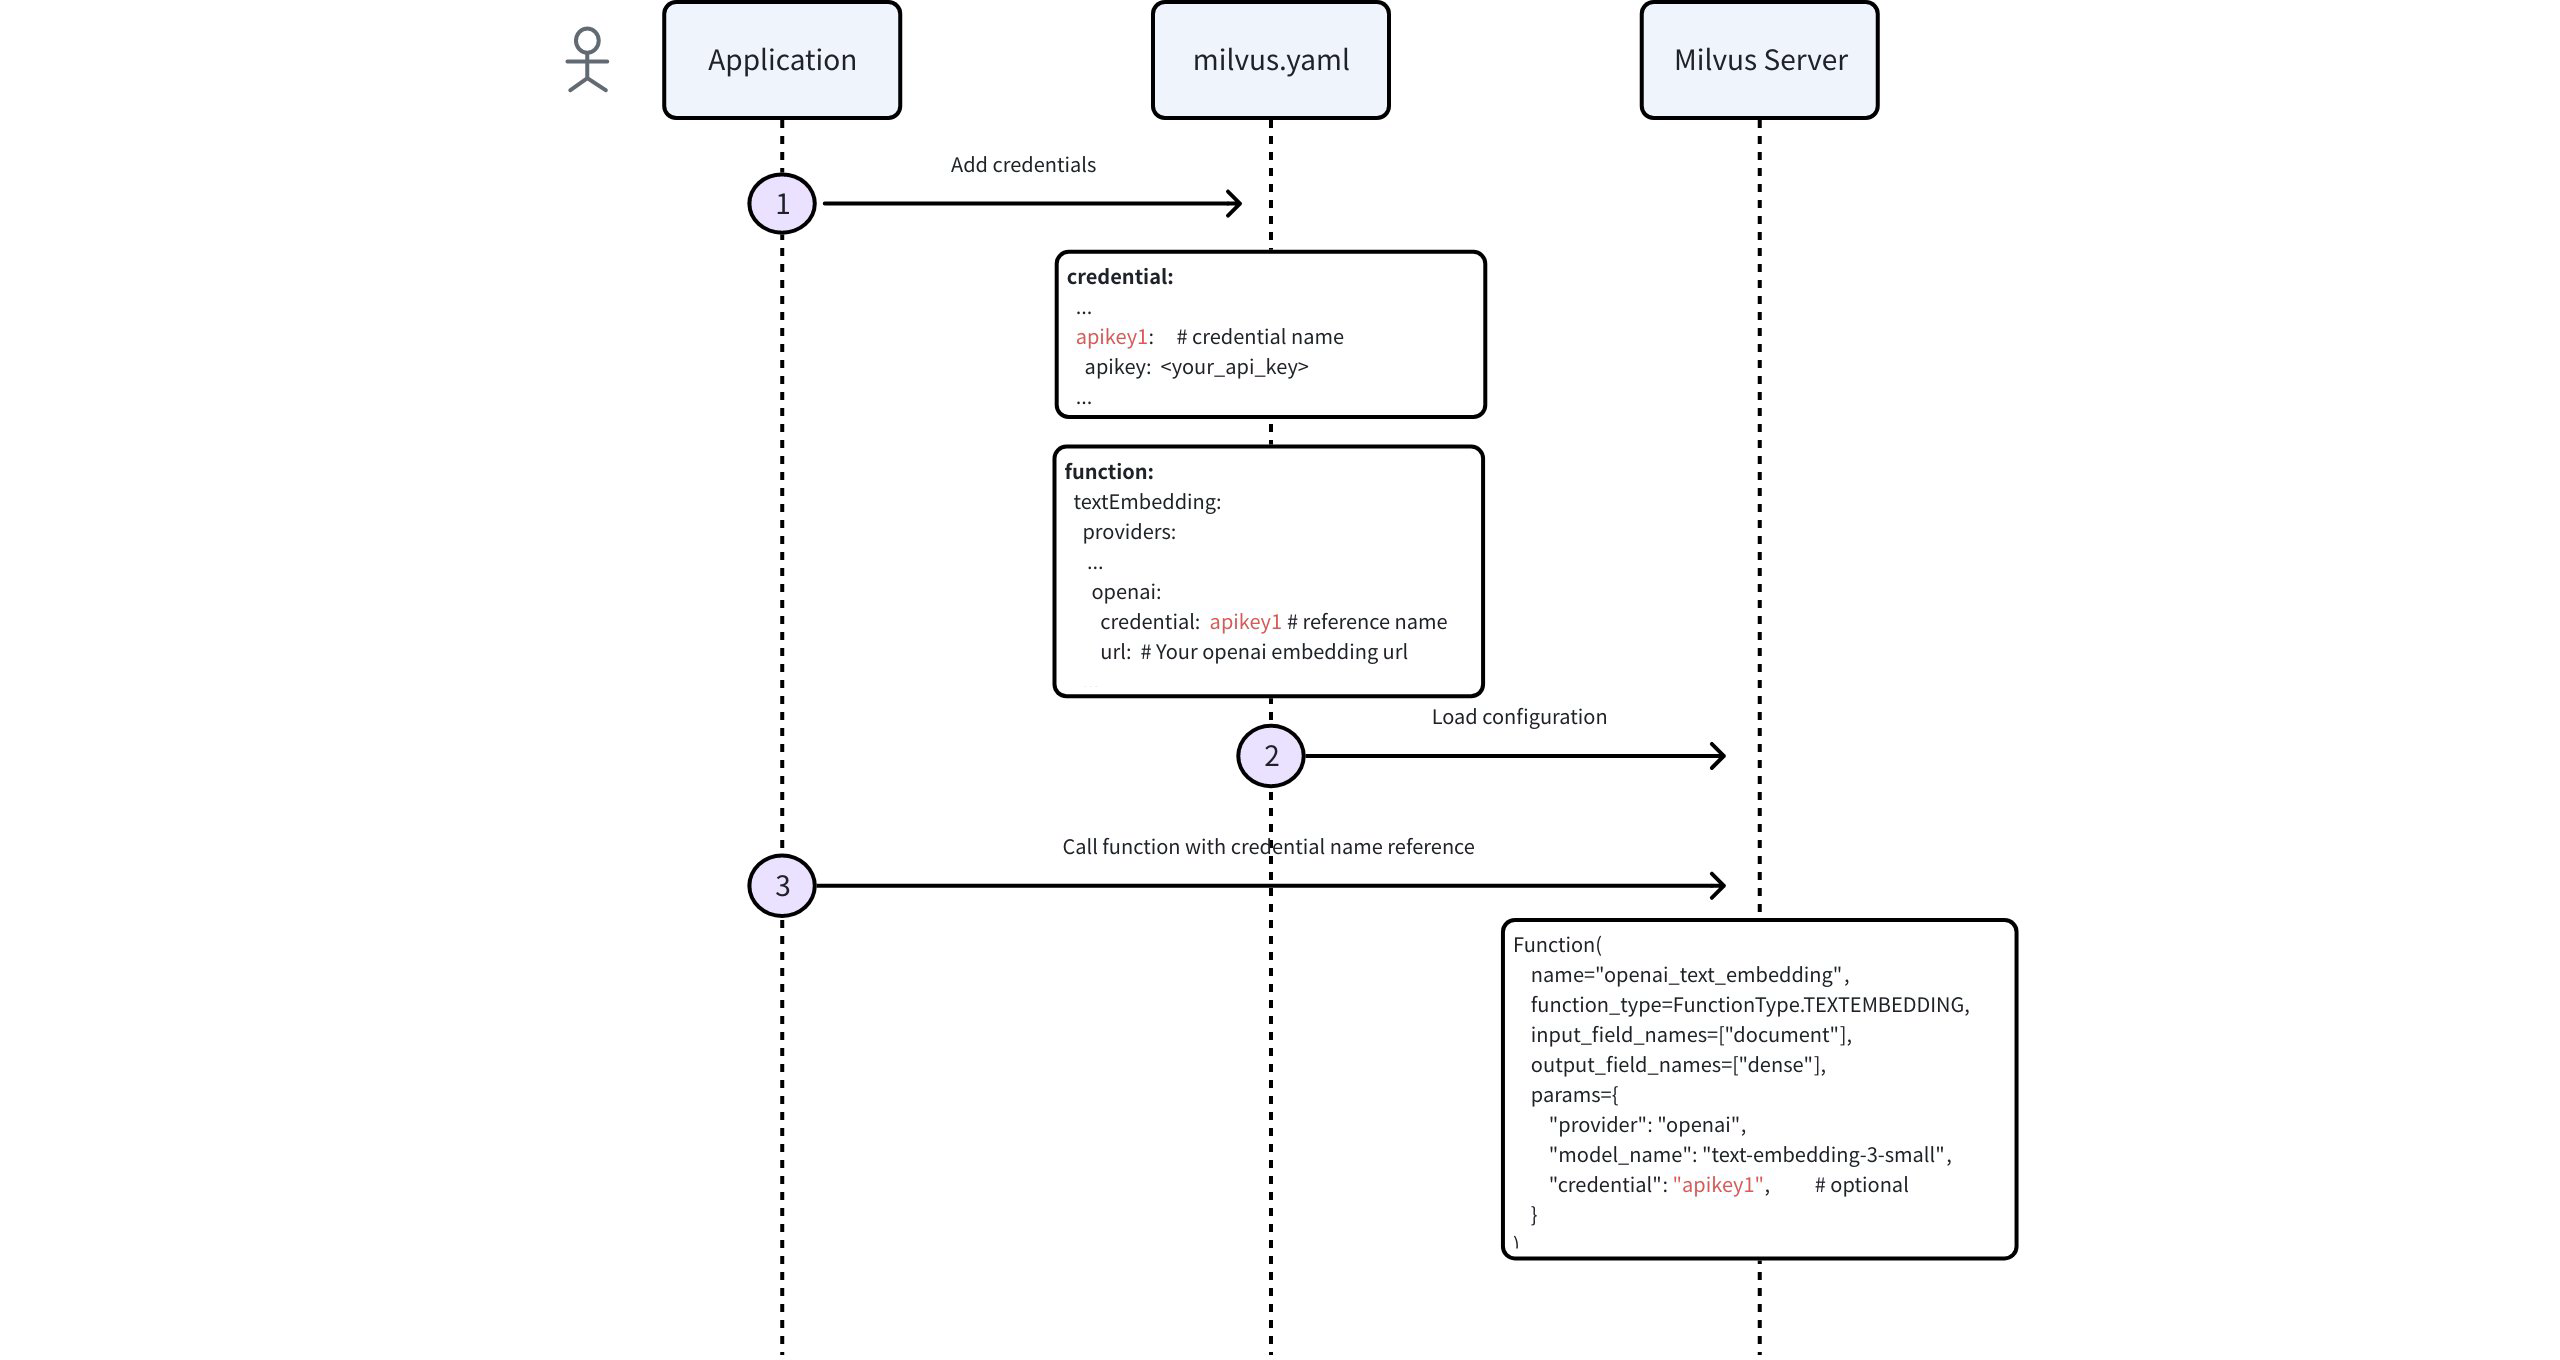 Konfigurasi Kredensial Overflow
Langkah 1: Tambahkan kredensial ke berkas konfigurasi Milvus
Di berkas milvus.yaml Anda, edit blok ` credential ` dengan entri untuk setiap penyedia yang perlu Anda akses:
# milvus.yaml credential store section
# This section defines all your authentication credentials for external embedding providers
# Each credential gets a unique name (e.g., aksk1, apikey1) that you'll reference elsewhere
credential:
  # For AWS Bedrock or services using access/secret key pairs
  # 'aksk1' is just an example name - you can choose any meaningful identifier
  aksk1:
    access_key_id: <YOUR_AK>
    secret_access_key: <YOUR_SK>

  # For OpenAI, Voyage AI, or other API key-based services
  # 'apikey1' is a custom name you choose to identify this credential
  apikey1:
    apikey: <YOUR_API_KEY>

  # For Google Vertex AI using service account credentials
  # 'gcp1' is an example name for your Google Cloud credentials
  gcp1:
    credential_json: <BASE64_OF_JSON>
Langkah 2: Konfigurasikan pengaturan penyedia
Di berkas konfigurasi yang sama (milvus.yaml), edit blok ` function ` untuk memberitahu Milvus kunci mana yang akan digunakan untuk menyematkan panggilan layanan:
function:
  textEmbedding:
    providers:
      openai:                         # calls OpenAI
        credential: apikey1           # Reference to the credential label
        # url:                        # (optional) custom url

      bedrock:                        # calls AWS Bedrock
        credential: aksk1             # Reference to the credential label
        region: us-east-2

      vertexai:                       # calls Google Vertex AI
        credential: gcp1              # Reference to the credential label
        # url:                        # (optional) custom url

      tei:                            # Built-in Tiny Embedding model
        enable: true                  # Whether to enable TEI model service
Untuk informasi lebih lanjut tentang cara menerapkan konfigurasi Milvus, lihat Konfigurasi Milvus secara Langsung.
Gunakan fungsi embedding
Setelah kredensial dikonfigurasi dalam berkas konfigurasi Milvus Anda, ikuti langkah-langkah berikut untuk mendefinisikan dan menggunakan fungsi embedding.
Langkah 1: Tentukan bidang skema
Untuk menggunakan fungsi embedding, buat koleksi dengan skema tertentu. Skema ini harus mencakup setidaknya tiga bidang yang diperlukan:
Bidang utama yang secara unik mengidentifikasi setiap entitas dalam koleksi.
Bidang skalar yang menyimpan data mentah yang akan di-embed.
Sebuah bidang vektor yang disediakan untuk menyimpan embedding vektor yang akan dihasilkan oleh fungsi tersebut untuk bidang skalar.
Contoh berikut mendefinisikan skema dengan satu bidang skalar "document" untuk menyimpan data teks dan satu bidang vektor "dense" untuk menyimpan embedding yang akan dihasilkan oleh modul Function. Pastikan untuk mengatur dimensi vektor (dim) agar sesuai dengan output model embedding yang Anda pilih.
from pymilvus import MilvusClient, DataType, Function, FunctionType

# Initialize Milvus client
client = MilvusClient(
    uri="http://localhost:19530",
)

# Create a new schema for the collection
schema = client.create_schema()

# Add primary field "id"
schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)

# Add scalar field "document" for storing textual data
schema.add_field("document", DataType.VARCHAR, max_length=9000)

# Add vector field "dense" for storing embeddings.
# IMPORTANT: Set dim to match the exact output dimension of the embedding model.
# For instance, OpenAI's text-embedding-3-small model outputs 1536-dimensional vectors.
# For dense vector, data type can be FLOAT_VECTOR or INT8_VECTOR
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=1536)
// java
// nodejs
// go
# restful
Langkah 2: Tambahkan fungsi embedding ke skema
Modul Function di Milvus secara otomatis mengubah data mentah yang disimpan dalam bidang skalar menjadi embedding dan menyimpannya ke dalam bidang vektor yang telah ditentukan secara eksplisit.
Contoh di bawah ini menambahkan modul Function (openai_embedding) yang mengubah bidang skalar "document" menjadi embedding, lalu menyimpan vektor hasilnya ke dalam bidang vektor "dense" yang telah didefinisikan sebelumnya.
# Define embedding function (example: OpenAI provider)
text_embedding_function = Function(
    name="openai_embedding",                  # Unique identifier for this embedding function
    function_type=FunctionType.TEXTEMBEDDING, # Type of embedding function
    input_field_names=["document"],           # Scalar field to embed
    output_field_names=["dense"],             # Vector field to store embeddings
    params={                                  # Provider-specific configuration (highest priority)
        "provider": "openai",                 # Embedding model provider
        "model_name": "text-embedding-3-small",     # Embedding model
        # "credential": "apikey1",            # Optional: Credential label
        # Optional parameters:
        # "dim": "1536",       # Optionally shorten the vector dimension
        # "user": "user123"    # Optional: identifier for API tracking
    }
)

# Add the embedding function to your schema
schema.add_function(text_embedding_function)
// java
// nodejs
// go
# restful
Parameter |
Deskripsi |
Nilai Contoh |
|---|---|---|
|
Pengidentifikasi unik untuk fungsi embedding di dalam Milvus. |
|
|
Jenis fungsi yang digunakan. Untuk embedding teks, atur nilainya menjadi Catatan: Milvus menerima |
|
|
Bidang skalar yang berisi data mentah yang akan di-embed. Saat ini, parameter ini hanya menerima satu nama bidang. |
|
|
Bidang vektor untuk menyimpan embedding yang dihasilkan. Saat ini, parameter ini hanya menerima satu nama bidang. |
|
|
Kamus yang berisi konfigurasi embedding. Catatan: Parameter dalam " |
|
|
Penyedia model embedding. |
|
|
Menentukan model embedding mana yang akan digunakan. |
|
|
Label kredensial yang didefinisikan di bagian `
|
|
|
Jumlah dimensi untuk embedding keluaran. Untuk model generasi ketiga OpenAI, Anda dapat mempersingkat vektor penuh untuk mengurangi biaya dan latensi tanpa kehilangan informasi semantik yang signifikan. Untuk informasi lebih lanjut, lihat postingan blog pengumuman OpenAI. Catatan: Jika Anda mempersingkat dimensi vektor, pastikan nilai ` |
|
|
Pengidentifikasi tingkat pengguna untuk melacak penggunaan API. |
|
Untuk koleksi dengan beberapa bidang skalar yang memerlukan konversi teks ke vektor, tambahkan fungsi terpisah ke skema koleksi, pastikan setiap fungsi memiliki nama dan nilai ` output_field_names ` yang unik.
Langkah 3: Konfigurasi indeks
Setelah mendefinisikan skema dengan bidang yang diperlukan dan fungsi bawaan, atur indeks untuk koleksi Anda. Untuk menyederhanakan proses ini, gunakan ` AUTOINDEX ` sebagai ` index_type`, opsi yang memungkinkan Milvus memilih dan mengonfigurasi jenis indeks yang paling sesuai berdasarkan struktur data Anda.
# Prepare index parameters
index_params = client.prepare_index_params()

# Add AUTOINDEX to automatically select optimal indexing method
index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
// java
// nodejs
// go
# restful
Langkah 4: Buat koleksi
Sekarang buat koleksi menggunakan skema dan parameter indeks yang telah ditentukan.
# Create collection named "demo"
client.create_collection(
    collection_name='demo',
    schema=schema,
    index_params=index_params
)
// java
// nodejs
// go
# restful
Langkah 5: Masukkan data
Setelah menyiapkan koleksi dan indeks Anda, Anda siap untuk memasukkan data mentah Anda. Dalam proses ini, Anda hanya perlu menyediakan teks mentah. Modul Fungsi yang telah kita tentukan sebelumnya secara otomatis menghasilkan vektor spars yang sesuai untuk setiap entri teks.
# Insert sample documents
client.insert('demo', [
    {'id': 1, 'document': 'Milvus simplifies semantic search through embeddings.'},
    {'id': 2, 'document': 'Vector embeddings convert text into searchable numeric data.'},
    {'id': 3, 'document': 'Semantic search helps users find relevant information quickly.'},
])
// java
// nodejs
// go
# restful
Langkah 6: Lakukan pencarian vektor
Setelah memasukkan data, lakukan pencarian semantik menggunakan teks kueri mentah. Milvus secara otomatis mengubah kueri Anda menjadi vektor embedding, mengambil dokumen yang relevan berdasarkan kesamaan, dan menampilkan hasil yang paling cocok.
# Perform semantic search
results = client.search(
    collection_name='demo',
    data=['How does Milvus handle semantic search?'], # Use text query rather than query vector
    anns_field='dense',   # Use the vector field that stores embeddings
    limit=1,
    output_fields=['document'],
)

print(results)

# Example output:
# data: ["[{'id': 1, 'distance': 0.8821347951889038, 'entity': {'document': 'Milvus simplifies semantic search through embeddings.'}}]"]
// java
// nodejs
// go
# restful
Untuk informasi lebih lanjut tentang operasi pencarian dan kueri, lihat Pencarian Vektor Dasar dan Kueri.
FAQ
Apa perbedaan antara mengonfigurasi kredensial di milvus.yaml dengan menggunakan variabel lingkungan?
Kedua metode tersebut dapat digunakan, namun penggunaan ` milvus.yaml ` merupakan pendekatan yang direkomendasikan karena menyediakan pengelolaan kredensial terpusat dan penamaan kredensial yang konsisten di seluruh penyedia layanan. Saat menggunakan variabel lingkungan, nama variabel bervariasi tergantung pada penyedia layanan embedding, jadi silakan merujuk ke halaman khusus masing-masing penyedia untuk memahami nama variabel lingkungan spesifik yang diperlukan (misalnya, OpenAI atau Azure OpenAI).
Apa yang terjadi jika saya tidak menentukan parameter kredensial dalam definisi fungsi?
Milvus mengikuti urutan resolusi kredensial berikut:
- Pertama, Milvus mencari kredensial default yang dikonfigurasi untuk penyedia tersebut di berkas `
milvus.yaml` - Jika tidak ada kredensial default di milvus.yaml, sistem akan beralih ke variabel lingkungan (jika telah dikonfigurasi)
- Jika kredensial di `
milvus.yaml` maupun variabel lingkungan tidak dikonfigurasi, Milvus akan menampilkan pesan kesalahan
Bagaimana cara memverifikasi bahwa embedding dihasilkan dengan benar?
Anda dapat memeriksanya dengan:
- Melakukan kueri pada koleksi Anda setelah penyisipan untuk melihat apakah bidang vektor berisi data
- Memastikan panjang bidang vektor sesuai dengan dimensi yang Anda harapkan
- Melakukan pencarian kesamaan sederhana untuk memverifikasi bahwa embeddings menghasilkan hasil yang bermakna
Saat saya melakukan pencarian kesamaan, apakah saya bisa menggunakan vektor kueri daripada teks mentah?
Ya, Anda dapat menggunakan vektor kueri yang telah dihitung sebelumnya sebagai pengganti teks mentah untuk pencarian kesamaan. Meskipun modul Fungsi secara otomatis mengonversi kueri teks mentah menjadi embedding, Anda juga dapat langsung menyediakan data vektor ke parameter ` data ` dalam operasi pencarian Anda. Catatan: Ukuran dimensi vektor kueri yang Anda berikan harus konsisten dengan ukuran dimensi vektor embedding yang dihasilkan oleh modul Fungsi Anda.
Contoh:
# Using raw text (Function module converts automatically)
results = client.search(
    collection_name='demo',
    data=['How does Milvus handle semantic search?'],
    anns_field='dense',
    limit=1
)

# Using pre-computed query vector (must match stored vector dimensions)
query_vector = [0.1, 0.2, 0.3, ...]  # Must be same dimension as stored embeddings
results = client.search(
    collection_name='demo',
    data=[query_vector],
    anns_field='dense',
    limit=1
)
// java
// nodejs
// go
# restful
