

Fonction MinHashCompatible with Milvus 3.0.x
La fonction MinHash convertit du texte brut en vecteurs binaires qui fournissent une approximation de la similarité de Jaccard entre les documents. Elle applique le découpage de texte (text shingling) et plusieurs fonctions de hachage pour produire des vecteurs de signature de longueur fixe, ce qui permet une détection rapide des quasi-doublons et une déduplication des documents à grande échelle.
En tant que fonction intégrée, MinHash s'exécute au sein de Milvus et ne nécessite ni inférence de modèle externe ni prétraitement. Il vous suffit d'insérer du texte brut pour que Milvus génère automatiquement les vecteurs de signature MinHash.
Contraintes
Le champ de sortie doit être un champ de type «
BINARY_VECTOR» dont la dimension satisfait à la conditiondim % 32 == 0, car chaque signature MinHash est une valeur de hachage de 32 bits.L’
dimdu champ de vecteurs binaires doit être égale à32 * num_hashes. Toute divergence entraîne une erreur.Lorsque l’on utilise l’index «
MINHASH_LSH» avec la sortie de la fonction MinHash, «mh_element_bit_width» doit être défini sur «32».
Fonctionnement de MinHash
MinHash est une technique de hachage sensible à la localité qui estime la similarité de Jaccard entre des ensembles. Dans Milvus, la fonction MinHash suit ce pipeline : vous fournissez du texte brut en entrée, et Milvus produit un vecteur binaire en sortie — en gérant toutes les étapes intermédiaires en interne.
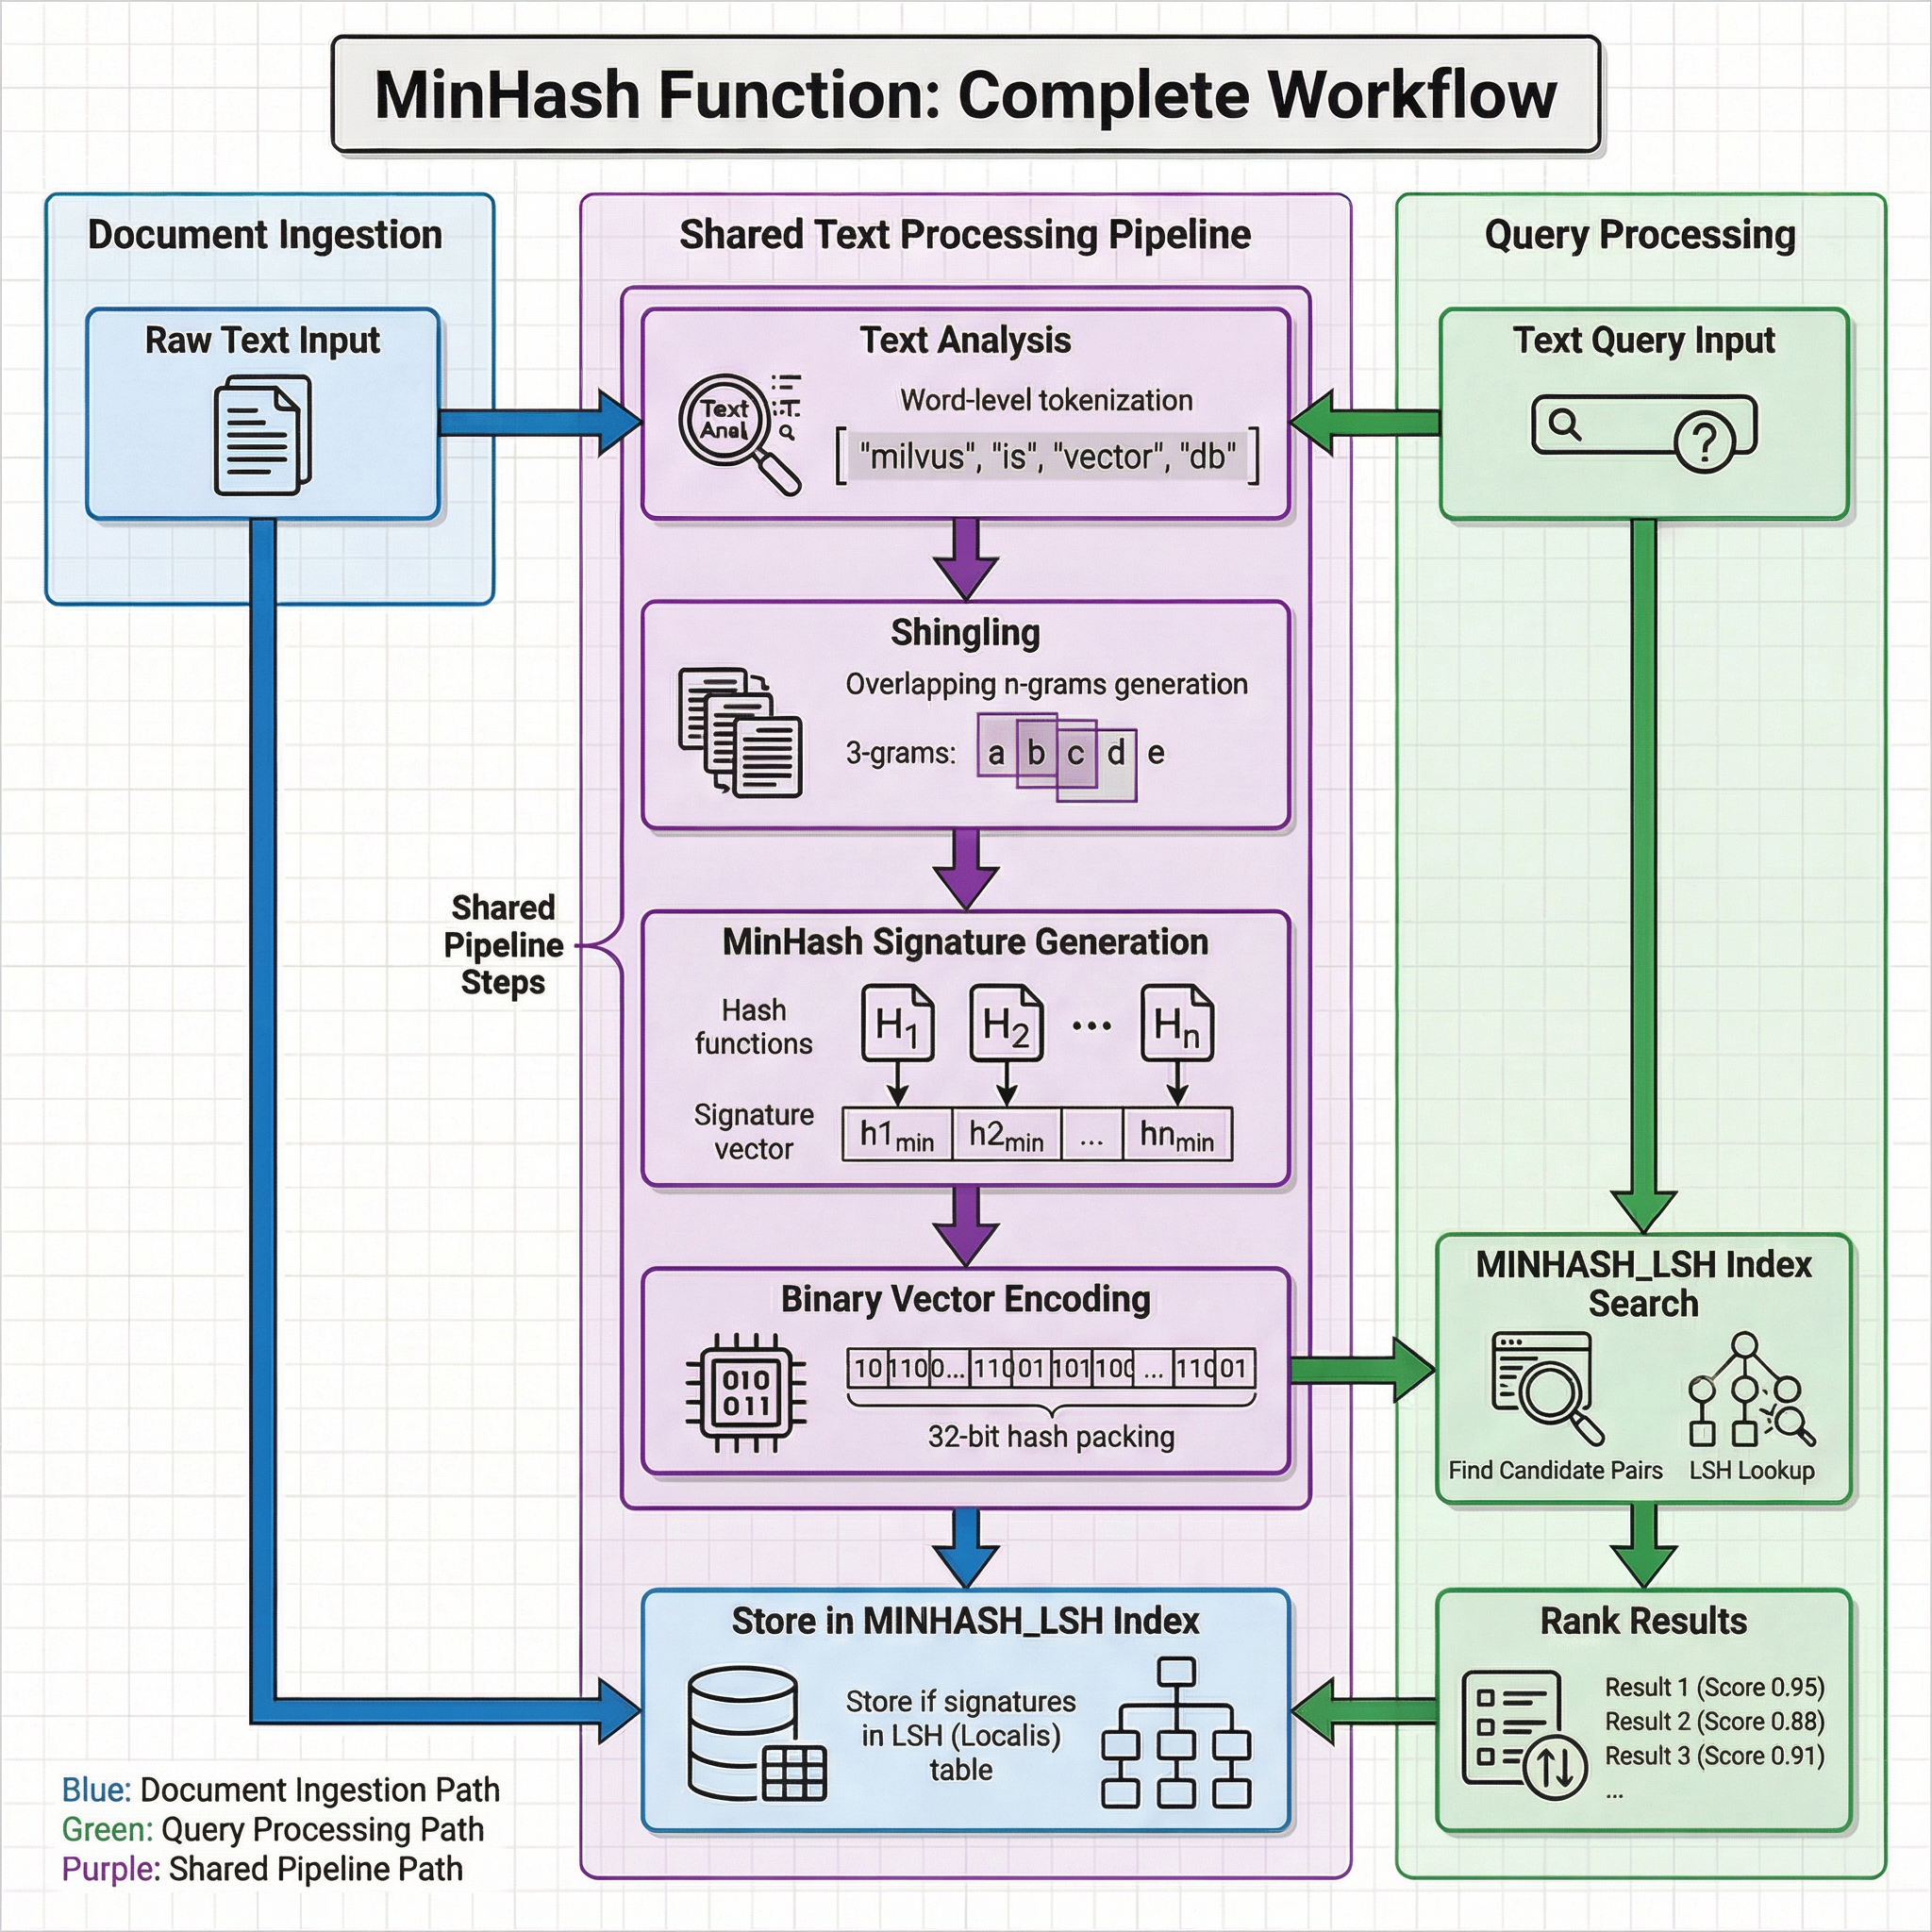
Le flux de travail global se compose d’un pipeline de traitement de texte partagé, utilisé à la fois pour l’ingestion des documents et le traitement des requêtes, suivi d’opérations spécifiques à chaque phase pour le stockage et la recherche.
 Iaqkbfeh8oqggsx6nsocfosondo
Pipeline de traitement de texte partagé
L’ingestion de documents et le traitement des requêtes font tous deux passer le texte brut par la même transformation en quatre étapes :
Analyse du texte: le texte est traité par un analyseur (lorsque
token_levelest"word") ou utilisé directement (lorsquetoken_levelest"char"). La tokenisation au niveau des mots applique l’analyseur configuré sur le champ d’entrée pour segmenter le texte en termes — par exemple,"milvus is vector db"devient["milvus", "is", "vector", "db"].Segmentation en « shingles »: les tokens sont divisés en n-grammes (shingles) qui se chevauchent, de taille
shingle_size. Par exemple, avec des 3-grammes au niveau des mots, les tokens["information", "retrieval", "is", "a", "field"]deviennent des shingles tels que["information retrieval is", "retrieval is a", "is a field"].Génération de la signature MinHash: plusieurs fonctions de hachage (H1, H2, …, Hn, où n =
num_hashes) sont appliquées à l’ensemble des shingles. Pour chaque fonction de hachage, la valeur de hachage minimale parmi tous les « shingles » est sélectionnée. L’ensemble de ces valeurs minimales forme la signature MinHash — une représentation de longueur fixe qui approxime la similarité de Jaccard du document d’origine.Codage en vecteur binaire: chaque valeur de signature est un hachage de 32 bits, et la signature complète est compressée dans un
BINARY_VECTORde dimension32 * num_hashes.
Ingestion de documents
Lors de l’insertion, le vecteur binaire produit par le pipeline partagé est stocké dans l’index MINHASH_LSH. L’index gère une table LSH (Locality-Sensitive Hashing) qui regroupe les signatures similaires dans les mêmes compartiments, ce qui permet une récupération rapide des candidats au moment de la requête.
Traitement des requêtes
Lors de la recherche, le texte de la requête passe par le même pipeline partagé pour produire un vecteur binaire. Ce vecteur est utilisé pour effectuer une recherche LSH dans l’index MINHASH_LSH, ce qui identifie rapidement les paires de candidats susceptibles d’être similaires. Sans raffinement de Jaccard, Milvus renvoie des candidats LSH qui ne sont pas classés selon la similarité de Jaccard estimée. Lorsque le raffinement Jaccard est activé, Milvus utilise les signatures MinHash brutes stockées pour classer les candidats en fonction de la similarité Jaccard estimée et renvoie les K meilleurs résultats.
Comme les deux méthodes partagent la même logique de transformation, deux documents dont le contenu se recoupe fortement produisent des signatures MinHash similaires. Cela rend cette fonction efficace pour détecter les quasi-doublons, même lorsque les documents diffèrent par l’ordre des mots, la mise en forme ou des nuances de formulation.
Avant de commencer
Avant d’utiliser la fonction MinHash, concevez le schéma de votre collection de manière à inclure les éléments suivants :
Un champ de texte pour le contenu brut
Votre collection doit inclure un champ «
VARCHAR» pour stocker le texte brut. Ce champ sert d’entrée à la fonction MinHash.Un analyseur pour le champ de texte (en cas d’utilisation de la tokenisation au niveau des mots)
Si «
token_level» est défini sur «"word"» (par défaut), l’analyseur du champ de texte doit être activé. L’analyseur définit la manière dont le texte est tokenisé avant le shingling. Par défaut, Milvus utilise l’analyseur «standard». Pour configurer un autre analyseur, consultez la section « Choisir l’analyseur adapté à votre cas d’utilisation ».Un champ de vecteurs binaires pour la sortie MinHash
Votre collection doit inclure un champ de type «
BINARY_VECTOR» pour stocker les vecteurs binaires générés par la fonction MinHash. La dimension doit être égale à «32 * num_hashes».
Étape 1 : Créer une collection avec une fonction MinHash
Pour utiliser la fonction MinHash, définissez-la lors de la création de la collection. La fonction est alors intégrée au schéma de la collection et s’applique automatiquement lors de l’insertion et de la recherche de données.
Définir les champs du schéma
Le schéma de votre collection doit inclure au moins trois champs :
Champ principal: identifie de manière unique chaque entité de la collection.
Champ texte (
VARCHAR) : stocke les documents texte bruts. Définissez l’enable_analyzer=Truee afin que Milvus puisse traiter le texte pour la génération de la signature MinHash. Par défaut, Milvus utilise l’analyseurstandardpour l’analyse de texte. Pour configurer un autre analyseur, reportez-vous à la section « Choisir l’analyseur adapté à votre cas d’utilisation ».Champ de vecteurs binaires (
BINARY_VECTOR) : stocke les vecteurs binaires générés automatiquement par la fonction MinHash. La dimension doit être égale à32 * num_hashes.
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(uri="http://localhost:19530", token="root:Milvus")

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)
schema.add_field(field_name="document_content", datatype=DataType.VARCHAR, max_length=9000, enable_analyzer=True)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=8192)
// java
// nodejs
// go
# restful
Définir la fonction MinHash
La fonction MinHash convertit le texte analysé en vecteurs binaires qui fournissent une approximation de la similarité de Jaccard entre les documents.
Définissez la fonction et ajoutez-la à votre schéma :
minhash_function = Function(
    name="minhash_function",
    input_field_names=["document_content"], # Name of the VARCHAR field containing raw text
    output_field_names=["binary_vector"], # Name of the BINARY_VECTOR field for generated signatures
    function_type=FunctionType.MINHASH,
    params={
        "num_hashes": 256, # Number of hash functions; produces dim = 32 * 256 = 8192
        "shingle_size": 3, # N-gram size for shingling
    }
)

schema.add_function(minhash_function)
// java
// nodejs
// go
# restful
Options de configuration
Le dictionnaire « params » de la fonction MinHash accepte les paramètres suivants. Les noms de paramètres ne sont pas sensibles à la casse.
Paramètre |
Type |
Valeur par défaut |
Description |
|---|---|---|---|
|
int |
Dérivé de |
Nombre de fonctions de hachage utilisées pour la génération de la signature. La dimension du vecteur binaire de sortie est égale à |
|
int |
|
Taille du N-gramme pour le shingling. Au niveau des mots : 1 à 3 en général. Au niveau des caractères : 2 à 6 en général. |
|
str |
|
Fonction de hachage à utiliser. Options :
|
|
str |
|
Niveau de tokenisation. Options :
|
|
int |
|
Graine aléatoire pour l’initialisation de la fonction MinHash. |
Configurer l’index
Le type d’index recommandé pour les vecteurs binaires MinHash est « MINHASH_LSH », avec le type de métrique « MHJACCARD ».
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_lsh_band": 128,
        "mh_element_bit_width": 32,
        "with_raw_data": True,
    },
)
// java
// nodejs
// go
# restful
Définissez ` with_raw_data ` sur ` True ` si les recherches utilisent le raffinement de Jaccard. Les signatures MinHash brutes sont nécessaires pour calculer la similarité de Jaccard estimée pour les candidats renvoyés par la recherche LSH.
Créer la collection
Créez la collection à l’aide du schéma et des paramètres d’index définis ci-dessus :
client.create_collection(
    collection_name="dedup_collection",
    schema=schema,
    index_params=index_params,
)
// java
// nodejs
// go
# restful
Étape 2 : Insérer des documents
Une fois votre collection configurée, insérez des données textuelles. Il vous suffit de fournir le texte brut : la fonction MinHash génère automatiquement le vecteur binaire pour chaque document.
client.insert(
    "dedup_collection",
    [
        {"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"},
        {"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"},
        {"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"},
    ],
)
// java
// nodejs
// go
# restful
Étape 3 : Effectuer une recherche avec MinHash
Une fois les données insérées, recherchez les documents quasi-duplicatas en saisissant des requêtes sous forme de texte brut. Milvus convertit automatiquement chaque requête en un vecteur binaire MinHash. Activez le raffinement Jaccard pour classer les candidats LSH en fonction de la similarité Jaccard estimée.
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,
        "refine_k": 3,
    },
}

results = client.search(
    collection_name="dedup_collection",
    data=["information retrieval is a research field focused on helping users find relevant data in large collections"],
    anns_field="binary_vector",
    limit=3,
    output_fields=["document_content"],
    search_params=search_params,
)

for hits in results:
    for hit in hits:
        print(f"ID: {hit['id']}, Distance: {hit['distance']}")
        print(f"Document: {hit['entity']['document_content']}")
// java
// nodejs
// go
# restful
Définissez ` mh_search_with_jaccard ` sur ` True ` pour activer le raffinement Jaccard. ` refine_k ` contrôle la capacité du pool de candidats utilisée pour le raffinement. Milvus utilise ` max(refine_k, limit) ` comme capacité, mais peut raffiner moins de candidats si la recherche LSH renvoie moins de correspondances. Augmenter ` refine_k ` peut améliorer la qualité des résultats au prix d’un surcroît de calcul.
Prochaines étapes
Recherche en texte intégral: utilisez BM25 pour le classement par pertinence lexicale au lieu de la détection des quasi-duplicatas.
Présentation des analyseurs: configurez des analyseurs personnalisés pour la tokenisation du texte.
Index MINHASH_LSH: découvrez comment ajuster les paramètres LSH pour optimiser le rappel et les performances.
