

Créer une collection externeCompatible with Milvus 3.0.x
Une collection externe est un type de collection de données dans Milvus qui accède aux données provenant de systèmes de stockage externes ou de tables de bases de données, tels qu'AWS S3 et Iceberg, sans les copier dans Milvus. Elle fait office de couche de requête au-dessus des lacs de données tout en conservant la compatibilité avec les interfaces de requête de Milvus.
Cette fonctionnalité nécessite Storage V3. Pour obtenir des instructions d’activation et connaître les considérations de compatibilité, consultez la section Storage V3.
Présentation
Dans un pipeline de données d’IA classique, les utilisateurs ont peut-être déjà stocké leurs données au format Parquet ou dans d’autres formats sur leur système de stockage, tel qu’AWS S3. Pour permettre à Milvus d’exploiter ces données stockées en externe, les utilisateurs doivent généralement les importer dans le stockage propre à Milvus à l’aide de pipelines ETL (Extract-Transform-Load).
Ce workflow consistant à « apporter ses données vers Milvus » génère des données redondantes difficiles à synchroniser et alourdit la charge de maintenance technique nécessaire pour garantir la cohérence des données.
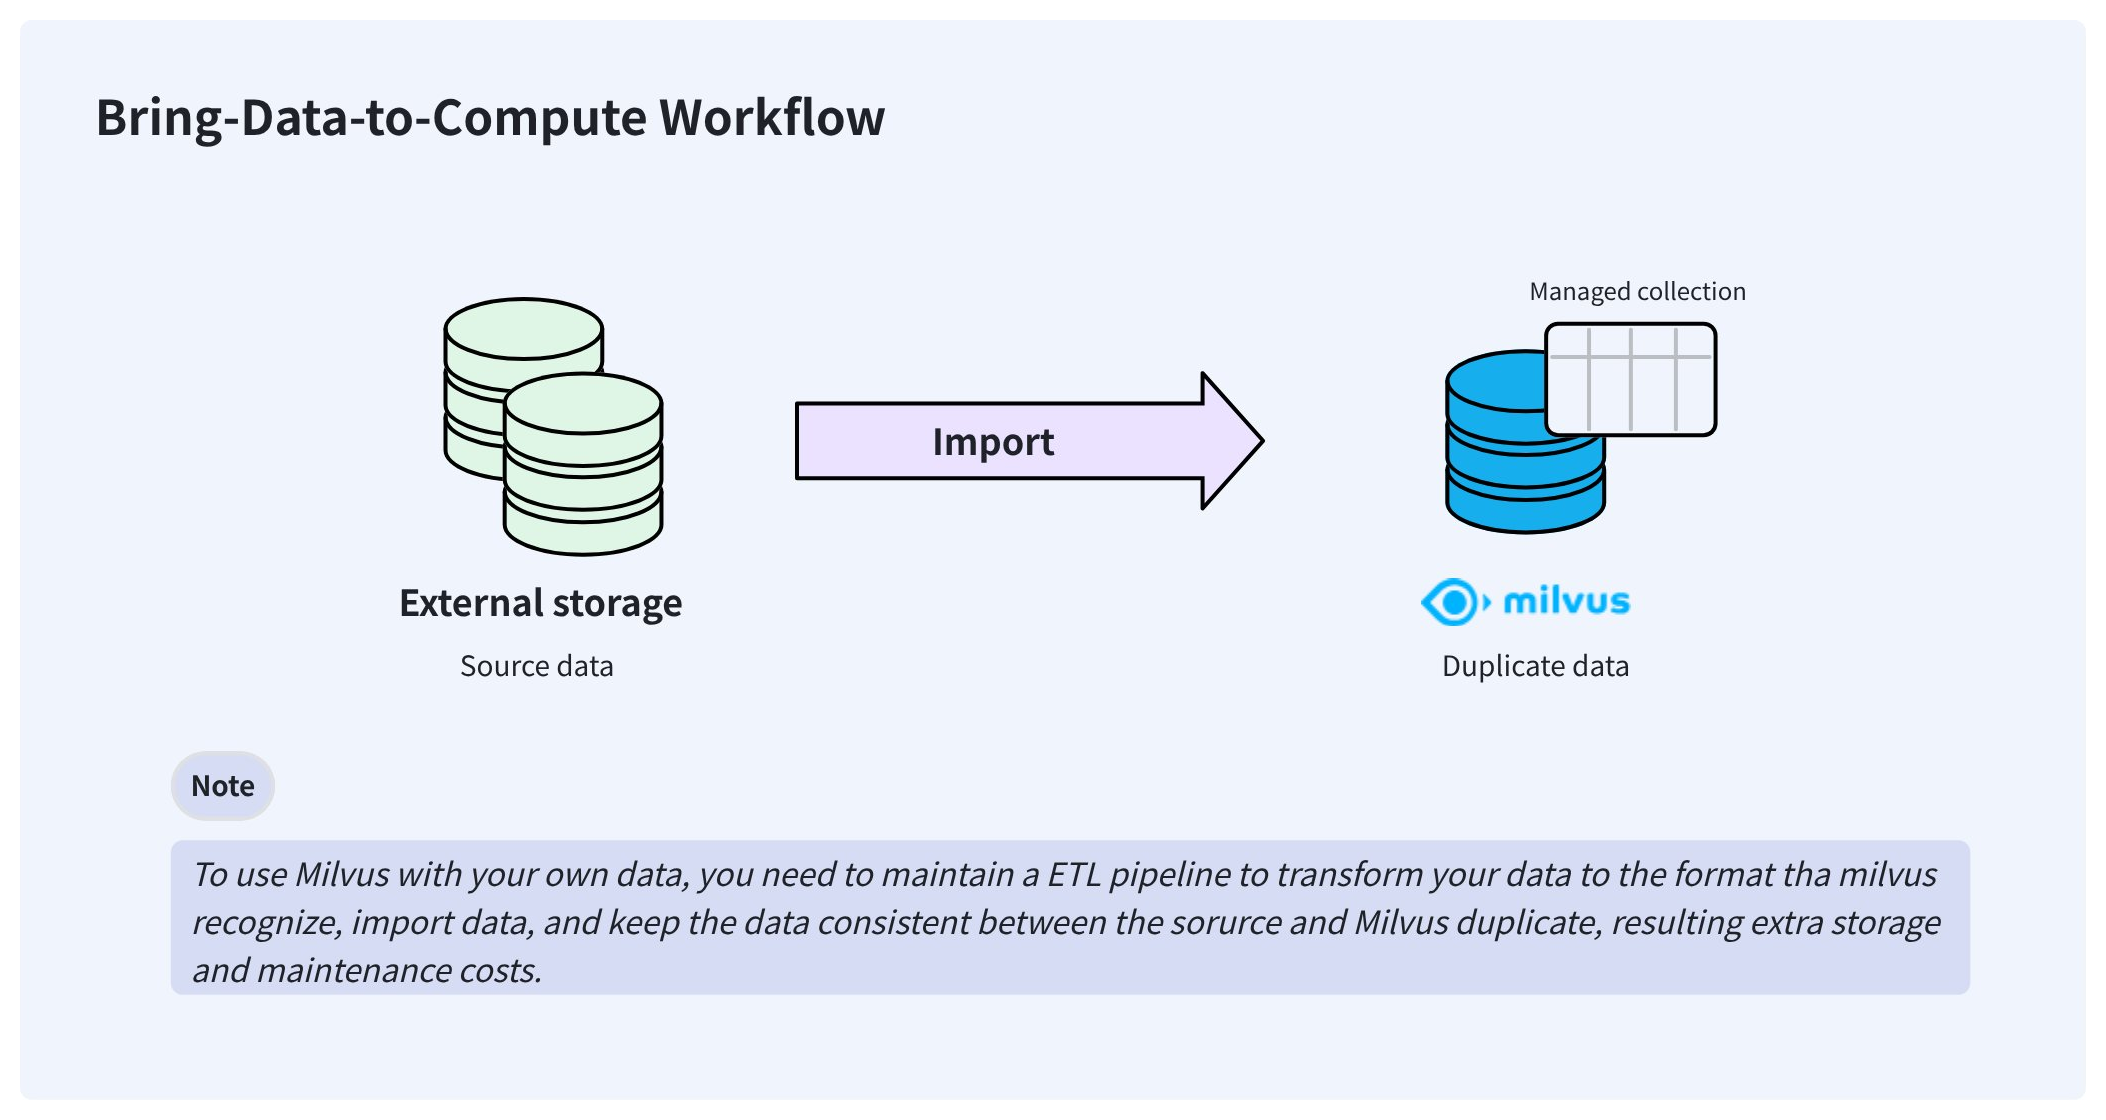 Workflow « Amener les données vers le système de calcul »
Pour résoudre ces problèmes, Milvus propose des collections externes qui vous permettent d’accéder à vos données stockées en externe depuis Milvus sans vous soucier de la synchronisation des données ni des pipelines ETL.
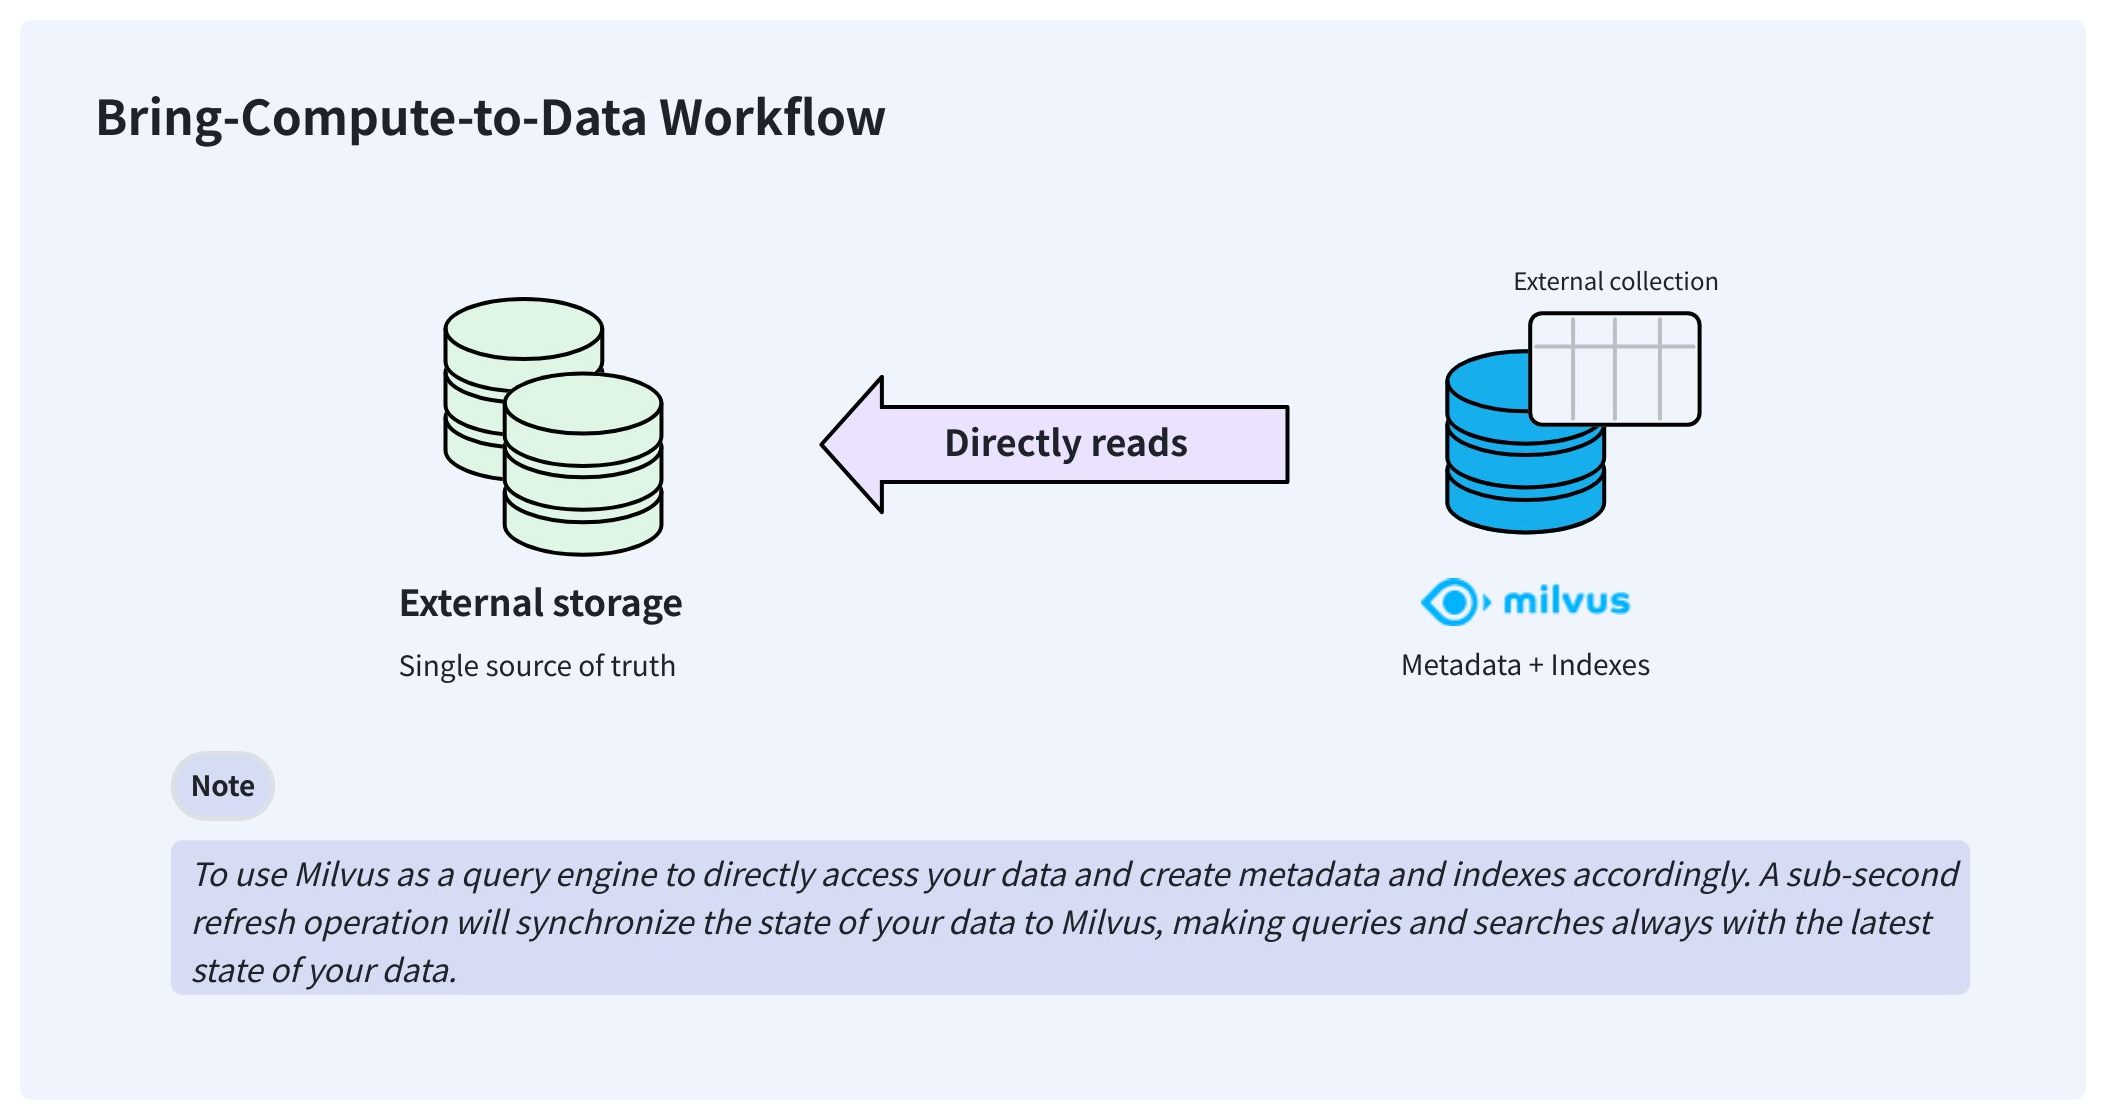 Workflow « Amener le calcul vers les données »
Une fois créée, une collection externe peut accéder directement à vos données et les conserver à l’emplacement même où vous les stockez. En arrière-plan, Milvus crée des fichiers de manifeste pour enregistrer les correspondances entre les métadonnées de Milvus et les lignes des fichiers de données externes. Une fois les fichiers de manifeste prêts, vous pouvez créer des index dans la collection externe comme vous le feriez dans n’importe quelle collection gérée.
Lorsque vos données changent, le déclenchement manuel d’une actualisation en moins d’une seconde met à jour les métadonnées, ce qui permet à Milvus de rester toujours à jour.
Étape 1 : Créer un schéma
Tout comme pour la création d’une collection gérée, vous devez également créer un schéma avant de créer une collection externe. Cependant, ce schéma est légèrement différent de celui d’une collection gérée.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(
    external_source='s3://s3.<region-id>.amazonaws.com/<bucket>/',
    external_spec='{
        "format": "parquet",
        "extfs": {
            ...
        }
    }'
)
import com.google.gson.JsonObject;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

JsonObject externalSpec = new JsonObject();
externalSpec.addProperty("format", "parquet");
externalSpec.add("extfs", new JsonObject());

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .externalSource("s3://s3.<region-id>.amazonaws.com/<bucket>/")
        .externalSpec(externalSpec)
        .build();
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

schema := entity.NewSchema().
    WithName("product_embeddings").
    WithExternalSource("s3://my-bucket/embeddings/").
    WithExternalSpec(`{"format": "parquet", "extfs": { ... }}`)
// node
export fields='[
        {
            "fieldName": "product_id",
            "dataType": "Int64",
            "isPrimary": true
        },
        {
            "fieldName": "embedding",
            "dataType": "FloatVector",
            "elementTypeParams": {
                "dim": "768"
            }
        },
        {
            "fieldName": "product_name",
            "dataType": "VarChar",
            "elementTypeParams": {
                "max_length": 512
            }
        }
    ]'
Pour créer le schéma d’une collection externe, vous devez spécifier l’URI des données source, le format des données et les paramètres d’authentification.
Nom du paramètre |
Description du paramètre |
Exemple de valeur |
|---|---|---|
|
Format des fichiers de données source cibles. |
|
|
Un identifiant de snapshot de table Iceberg valide. Ce paramètre s’applique uniquement lorsque vous définissez « |
|
|
Paramètres du système de fichiers externe sous forme de chaîne de caractères au format JSON. |
-- |
Vous disposez des options suivantes pour définir les paramètres d’authentification :
Utiliser AWS AK/SK
Cette option s'applique à MinIO auto-hébergé ou au cas où vous disposez d'un AK/SK pour votre travail.
{
    "format": "...",
    "extfs": {
        "access_key_id":     "AKIA..",
        "access_key_value":  "u4Lh...",
        "region":            "us-west-2",
        "cloud_provider":    "aws",
        "use_ssl":           "true",
        "use_virtual_host":  "true"
    }
}
Nom du paramètre |
Description du paramètre |
Exemple de valeur |
|---|---|---|
|
ID de la clé d'accès |
|
|
Valeur de la clé d'accès |
|
|
ID de la région cloud |
|
|
ID du fournisseur de cloud |
|
|
Indique si le protocole SSL est utilisé pour établir les connexions. |
|
|
Utilisation ou non de l'hébergement virtuel pour accéder à votre compartiment. Pour plus de détails, consultez cet article. |
|
Utiliser AWS IAM
Cette option s'applique au cas où Milvus s'exécute sur une instance EC2 ou un cluster EKS. Dans ce cas, vous n'avez pas besoin de coder en dur l'AK/SK.
{
    "format": "...",
    "extfs": {
        "use_iam":           "true",
        "iam_endpoint":      "https://sts.<region>.amazonaws.com",
        "region":            "us-west-2",
        "cloud_provider":    "aws",
        "use_ssl":           "true"
    }
}
Nom du paramètre |
Description du paramètre |
Exemple de valeur |
|---|---|---|
|
Indique s'il faut utiliser AWS IAM. Définissez cette option sur « |
|
|
Un point de terminaison AWS STS valide. Pour plus de détails, consultez cet article. |
|
|
ID de la région cloud |
|
|
ID du fournisseur de cloud |
|
|
Indique si le protocole SSL est utilisé pour établir les connexions. |
|
Utiliser les identifiants globaux Milvus
Cette option s'applique lorsque vous stockez des données externes dans le compartiment Milvus, et les paramètres globaux de MinIO spécifiés dans milvus.yaml peuvent être utilisés directement pour accéder aux données.
{
    "format": "...",
    "extfs": {
        "storage_type": "remote"
    }
}
Utiliser l’ARN du rôle IAM
Cette option s'applique lorsque votre organisation utilise différents comptes AWS pour gérer le cluster Milvus et le compartiment contenant les fichiers de données cibles.
Dans ce cas, le propriétaire du compartiment doit créer un rôle IAM qui
associe la politique «
AmazonS3FullAccess» ou une politique plus précise pour l’accès au compartiment.inclut une politique «
sts:ExternalId» personnalisée dans le champ « Condition » de la politique de confiance du rôle.
Ensuite, le propriétaire du compartiment doit vous fournir l’ARN du rôle IAM et l’identifiant externe afin que vous puissiez appeler ` sts:AssumeRole ` avec ces valeurs pour assumer le rôle IAM.
Voici un exemple de politique d’autorisation à associer au rôle IAM avec les autorisations accordées. Vous pouvez l’adapter en fonction de vos besoins.
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Effect": "Allow",
            "Action": [
                "s3:ListBucket",
                "s3:GetBucketLocation"
            ],
            "Resource": "arn:aws:s3:::SOURCE-DATA-BUCKET"
        },
        {
            "Effect": "Allow",
            "Action": [
                "s3:GetObject",
                "s3:PutObject",
                "s3:DeleteObject"
            ],
            "Resource": "arn:aws:s3:::SOURCE-DATA-BUCKET/*"
        }
    ]
}
La politique de confiance associée au rôle IAM définit qui est autorisé à l’assumer.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "AWS": "arn:aws:iam::ACCOUNT_RUNNING_MILVUS:root"
      },
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": {
          "sts:ExternalId": "YOUR_UNIQUE_EXTERNAL_ID"
        }
      }
    }
  ]
}
Une fois que vous avez obtenu l’ARN du rôle IAM et l’identifiant externe, vous pouvez configurer le paramètre ` external_spec ` comme suit :
{
    "format": "...",
    "extfs": {
        "cloud_provider": "aws",
        "region": "us-west-2",
        "storage_type": "remote",
        "use_ssl": "true",
        "use_iam": "true",
        "role_arn": "arn:aws:iam::306787000000:role/lentitude-bucket-role",
        "external_id": "YOUR_UNIQUE_EXTERNAL_ID",
        "load_frequency": "900"
    }
}
Nom du paramètre |
Description du paramètre |
Exemple de valeur |
|---|---|---|
|
ID du fournisseur de cloud |
|
|
ID de la région cloud |
|
|
Indique si le protocole SSL est utilisé pour établir les connexions. |
|
|
Indique si AWS IAM doit être utilisé. Pour cette option, définissez cette valeur sur « |
|
|
ARN du rôle IAM fourni par le propriétaire du compartiment. |
|
|
ID externe fourni par le propriétaire du compartiment. |
-- |
|
Intervalle, en secondes, auquel Milvus récupère les identifiants d'authentification temporaires. |
|
Étape 2 : Ajouter des champs
Une fois le schéma prêt, vous pouvez ajouter des champs comme suit :
schema.add_field(
    field_name="product_id",
    datatype=DataType.INT64,
    external_field="id" # field name in the external data file
)
schema.add_field(
    field_name="product_name",
    datatype=DataType.VARCHAR,
    max_length=512,
    external_field="name"
)
schema.add_field(
    field_name="embedding",
    datatype=DataType.FLOAT_VECTOR,
    dim=768,
    external_field="vector"
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("product_id")
        .dataType(DataType.Int64)
        .externalField("id")
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("product_name")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .externalField("name")
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .externalField("vector")
        .build());
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

schema = schema.
    WithField(
        entity.NewField().
            WithName("product_id").
            WithDataType(entity.FieldTypeInt64).
            WithExternalField("id"),
    ).
    WithField(
        entity.NewField().
            WithName("product_name").
            WithDataType(entity.FieldTypeVarChar).
            WithMaxLength(512).
            WithExternalField("name"),
    ).
    WithField(
        entity.NewField().
            WithName("embedding").
            WithDataType(entity.FieldTypeFloatVector).
            WithDim(768).
            WithExternalField("vector"),
    )
// node
export schema="{
    \"externalSource\": \"volume://my_volume/path/to/a/folder\",
    \"externalSpec\": \"{\\\"format\\\": \\\"parquet\\\"}\",
    \"fields\": $fields
}"
Étape 3 : Créer une collection
Après avoir ajouté tous les champs au schéma, vous pouvez créer la collection externe.
client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

client.create_collection(
    collection_name="test_collection",
    schema=schema
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

ConnectConfig connectConfig = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build();

MilvusClientV2 client = new MilvusClientV2(connectConfig);

CreateCollectionReq createReq = CreateCollectionReq.builder()
        .collectionName("test_collection")
        .collectionSchema(schema)
        .build();
client.createCollection(createReq);
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "http://localhost:19530"
token := "root:Milvus"

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
    APIKey: token
})

err = client.CreateCollection(ctx, milvusclient.NewCreateCollectionOption("test_collection", schema))

if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// node
curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"schema\": $schema
}"
Étape 4 : Créer des index
Vous pouvez créer des index pour les champs de la collection externe comme vous le feriez pour les collections gérées.
index_params = client.prepare_index_params()
# Add indexes
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
index_params.add_index(
    field_name="product_name",
    index_type="AUTOINDEX"
)
client.create_index(
    db_name="my_database",
    collection_name="test_collection",
    index_params=index_params
)
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.index.request.CreateIndexReq;
import java.util.*;

IndexParam indexParamForIdField = IndexParam.builder()
        .fieldName("product_name")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .build();
IndexParam indexParamForVectorField = IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build();
List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForIdField);
indexParams.add(indexParamForVectorField);
CreateIndexReq createIndexReq = CreateIndexReq.builder()
        .dbName("my_database")
        .collectionName("test_collection")
        .indexParams(indexParams)
        .build();
client.createIndex(createIndexReq);
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

collectionName := "test_collection"
indexOptions := []milvusclient.CreateIndexOption{
    milvusclient.NewCreateIndexOption(collectionName, "embedding", index.NewAutoIndex(entity.COSINE)),
    milvusclient.NewCreateIndexOption(collectionName, "product_name", index.NewAutoIndex(index.AUTOINDEX)),
}
indexTask, err := client.CreateIndex(ctx, indexOptions)
if err != nil {
    // handler err
}
err = indexTask.Await(ctx)
if err != nil {
    // handler err
}
client.createIndex({
    db_name: "my_database",
    collection_name: "test_collection",
    field_name: "product_name",
    index_type: "AUTOINDEX"
})
client.createIndex({
    db_name: "my_database",
    collection_name: "test_collection",
    field_name: "embedding",
    index_type: "AUTOINDEX",
    metric_type: "COSINE"
})
export indexParams='[
        {
            "fieldName": "embedding",
            "indexName": "my_vector",
            "indexType": "AUTOINDEX"
        },
        {
            "fieldName": "product_name",
            "indexName": "my_id",
            "indexType": "AUTOINDEX"
        }
    ]'

curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/indexes/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"indexParams\": $indexParams
}"
Étape 5 : Actualiser les données
Une fois la collection prête, actualisez-la pour créer les métadonnées et les index de vos données.
job_id = client.refresh_external_collection(
    db_name="my_database",
    collection_name="test_collection"
)
while True:
    progress = client.get_refresh_external_collection_progress(job_id=job_id)
    print(f"  {progress.state}: {progress.progress}%")
    if progress.state == "RefreshCompleted":
        elapsed = progress.end_time - progress.start_time
        print(f"  Completed in {elapsed}ms")
        break
    elif progress.state == "RefreshFailed":
        print(f"  Failed: {progress.reason}")
        break
    time.sleep(2)
import io.milvus.v2.service.utility.request.GetRefreshExternalCollectionProgressReq;
import io.milvus.v2.service.utility.request.ListRefreshExternalCollectionJobsReq;
import io.milvus.v2.service.utility.request.RefreshExternalCollectionReq;
import io.milvus.v2.service.utility.response.GetRefreshExternalCollectionProgressResp;
import io.milvus.v2.service.utility.response.ListRefreshExternalCollectionJobsResp;
import io.milvus.v2.service.utility.response.RefreshExternalCollectionJobInfo;
import io.milvus.v2.service.utility.response.RefreshExternalCollectionResp;

while (true) {
    GetRefreshExternalCollectionProgressResp resp = client.getRefreshExternalCollectionProgress(
            GetRefreshExternalCollectionProgressReq.builder()
                    .jobId(jobId)
                    .build());
    RefreshExternalCollectionJobInfo jobInfo = resp.getJobInfo();
    if ("RefreshCompleted".equals(jobInfo.getState())) {
        long elapsed = jobInfo.getEndTime() - jobInfo.getStartTime();
        System.out.printf("  Refresh completed in %dms%n", elapsed);
        break;
    } else if ("RefreshFailed".equals(jobInfo.getState())) {
        System.out.printf("  Refresh failed: %s%n", jobInfo.getReason());
    }
    TimeUnit.SECONDS.sleep(2);
}
refreshResult, err := client.RefreshExternalCollection(ctx,
    client.NewRefreshExternalCollectionOption("test_collection"))
jobID := refreshResult.JobID
for {
    progress, _ := client.GetRefreshExternalCollectionProgress(ctx,
        client.NewGetRefreshExternalCollectionProgressOption(jobID))
    fmt.Printf("State: %s\n", progress.State)
    if progress.State == entity.RefreshStateCompleted {
        fmt.Println("Refresh completed!")
        break
    }
    if progress.State == entity.RefreshStateFailed {
        fmt.Printf("Refresh failed: %s\n", progress.Reason)
        break
    }
    time.Sleep(2 * time.Second)
}
// node
curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/jobs/external_collection/refresh" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"externalSource\": \"volume://my_volume/path/to/a/folder\",
    \"externalSpec\": \"{\\\"format\\\": \\\"parquet\\\"}\"
}"
L'opération d'actualisation est asynchrone ; vous devez donc mettre en place une boucle pour surveiller sa progression.
L'opération d'actualisation analyse les métadonnées des fichiers de données et génère les fichiers de manifeste en conséquence. Elle prend généralement entre 150 et 250 ms.
Les fichiers de manifeste enregistrent le mappage entre les métadonnées dans Milvus et les lignes des fichiers externes.
En cas de mise à jour de vos données sources, vous devez relancer manuellement l’opération de rafraîchissement pour maintenir Milvus à jour.
Une opération de rafraîchissement nécessitant la suppression de toutes les métadonnées actives sans aucune insertion entraîne un refus.
Étapes suivantes
Une fois la collection externe actualisée, vous pouvez charger et valider la collection, puis effectuer des recherches de similarité et des requêtes dans la collection externe comme vous le feriez dans n’importe quelle collection gérée, à cette exception près que les collections d’une base de données destinée au calcul à la demande doivent être associées à un cluster à la demande pour les recherches et les requêtes.
Avant d’effectuer des opérations DQL, telles que la recherche, la requête, la récupération et la recherche hybride, vous devez créer une session pour associer les ressources de calcul d’un cluster à la demande.
Si la source de données externe contient ultérieurement un autre champ que vous souhaitez exposer dans Milvus, ajoutez un champ au schéma de la collection externe et actualisez à nouveau la collection externe. Pour plus de détails, reportez-vous à la section Modifier le schéma d’une collection externe.
