

Crear una colección externaCompatible with Milvus 3.0.x
Una colección externa es un tipo de colección de datos en Milvus que accede a datos procedentes de sistemas de almacenamiento externos o tablas de bases de datos, como AWS S3 e Iceberg, sin copiarlos en Milvus. Actúa como una capa de consulta sobre los lagos de datos, al tiempo que mantiene la compatibilidad con las interfaces de consulta de Milvus.
Esta función requiere Storage V3. Para obtener instrucciones de activación y consideraciones de compatibilidad, consulta Storage V3.
Descripción general
En un flujo de trabajo típico de datos de IA, es posible que los usuarios ya hayan almacenado sus datos en formato Parquet u otros formatos en su sistema de almacenamiento, como AWS S3. Para que Milvus pueda utilizar estos datos almacenados externamente, los usuarios suelen tener que importarlos al propio almacenamiento de Milvus mediante flujos de trabajo de extracción, transformación y carga (ETL).
Este flujo de trabajo de «traer tus datos a Milvus» genera datos redundantes que son difíciles de sincronizar y aumenta la carga de mantenimiento técnico para garantizar la coherencia de los datos.
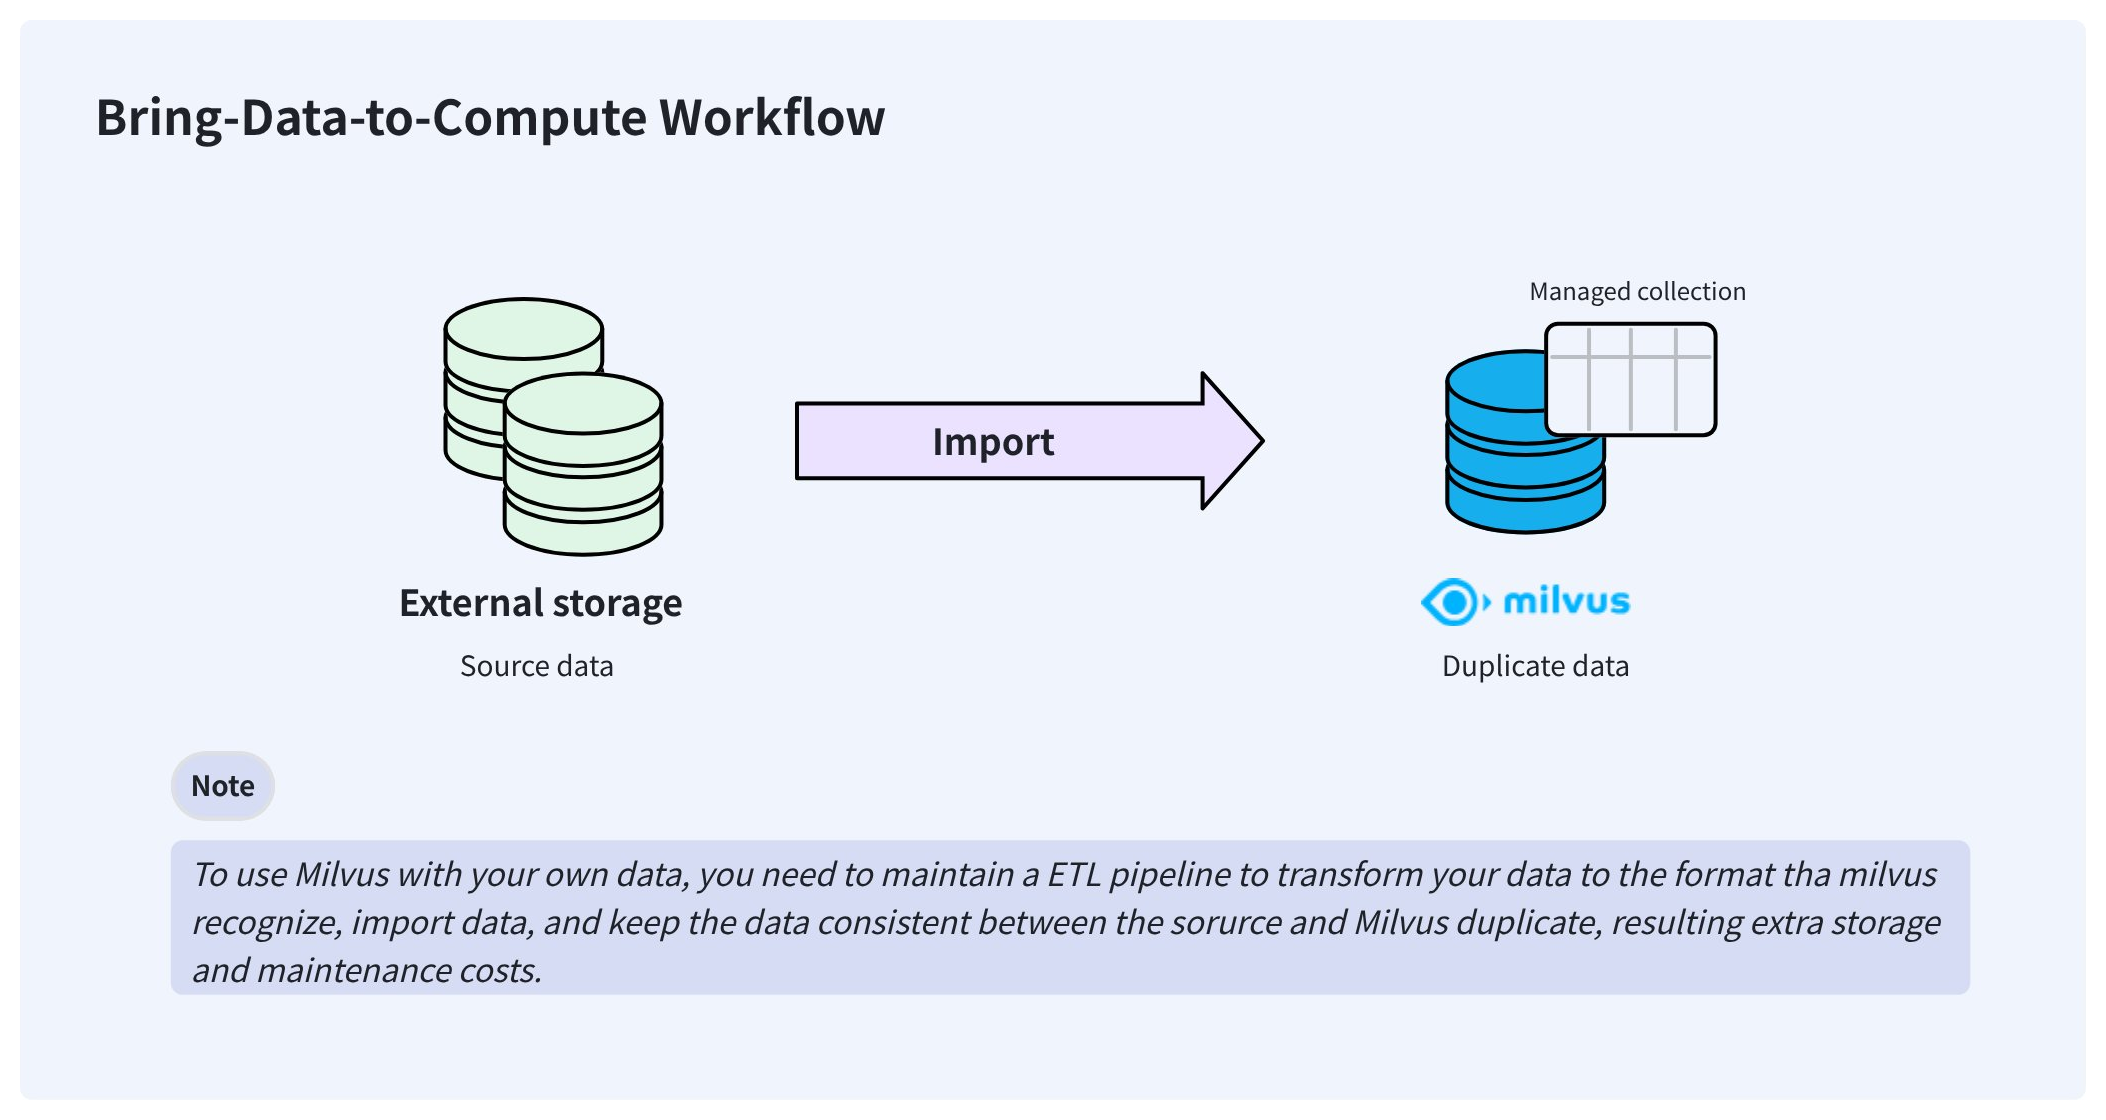 Flujo de trabajo «traer los datos al sistema de cálculo »
Para resolver estos problemas, Milvus ofrece colecciones externas que te permiten acceder a tus datos almacenados externamente desde Milvus sin tener que preocuparte por la sincronización de datos ni por los flujos de trabajo ETL.
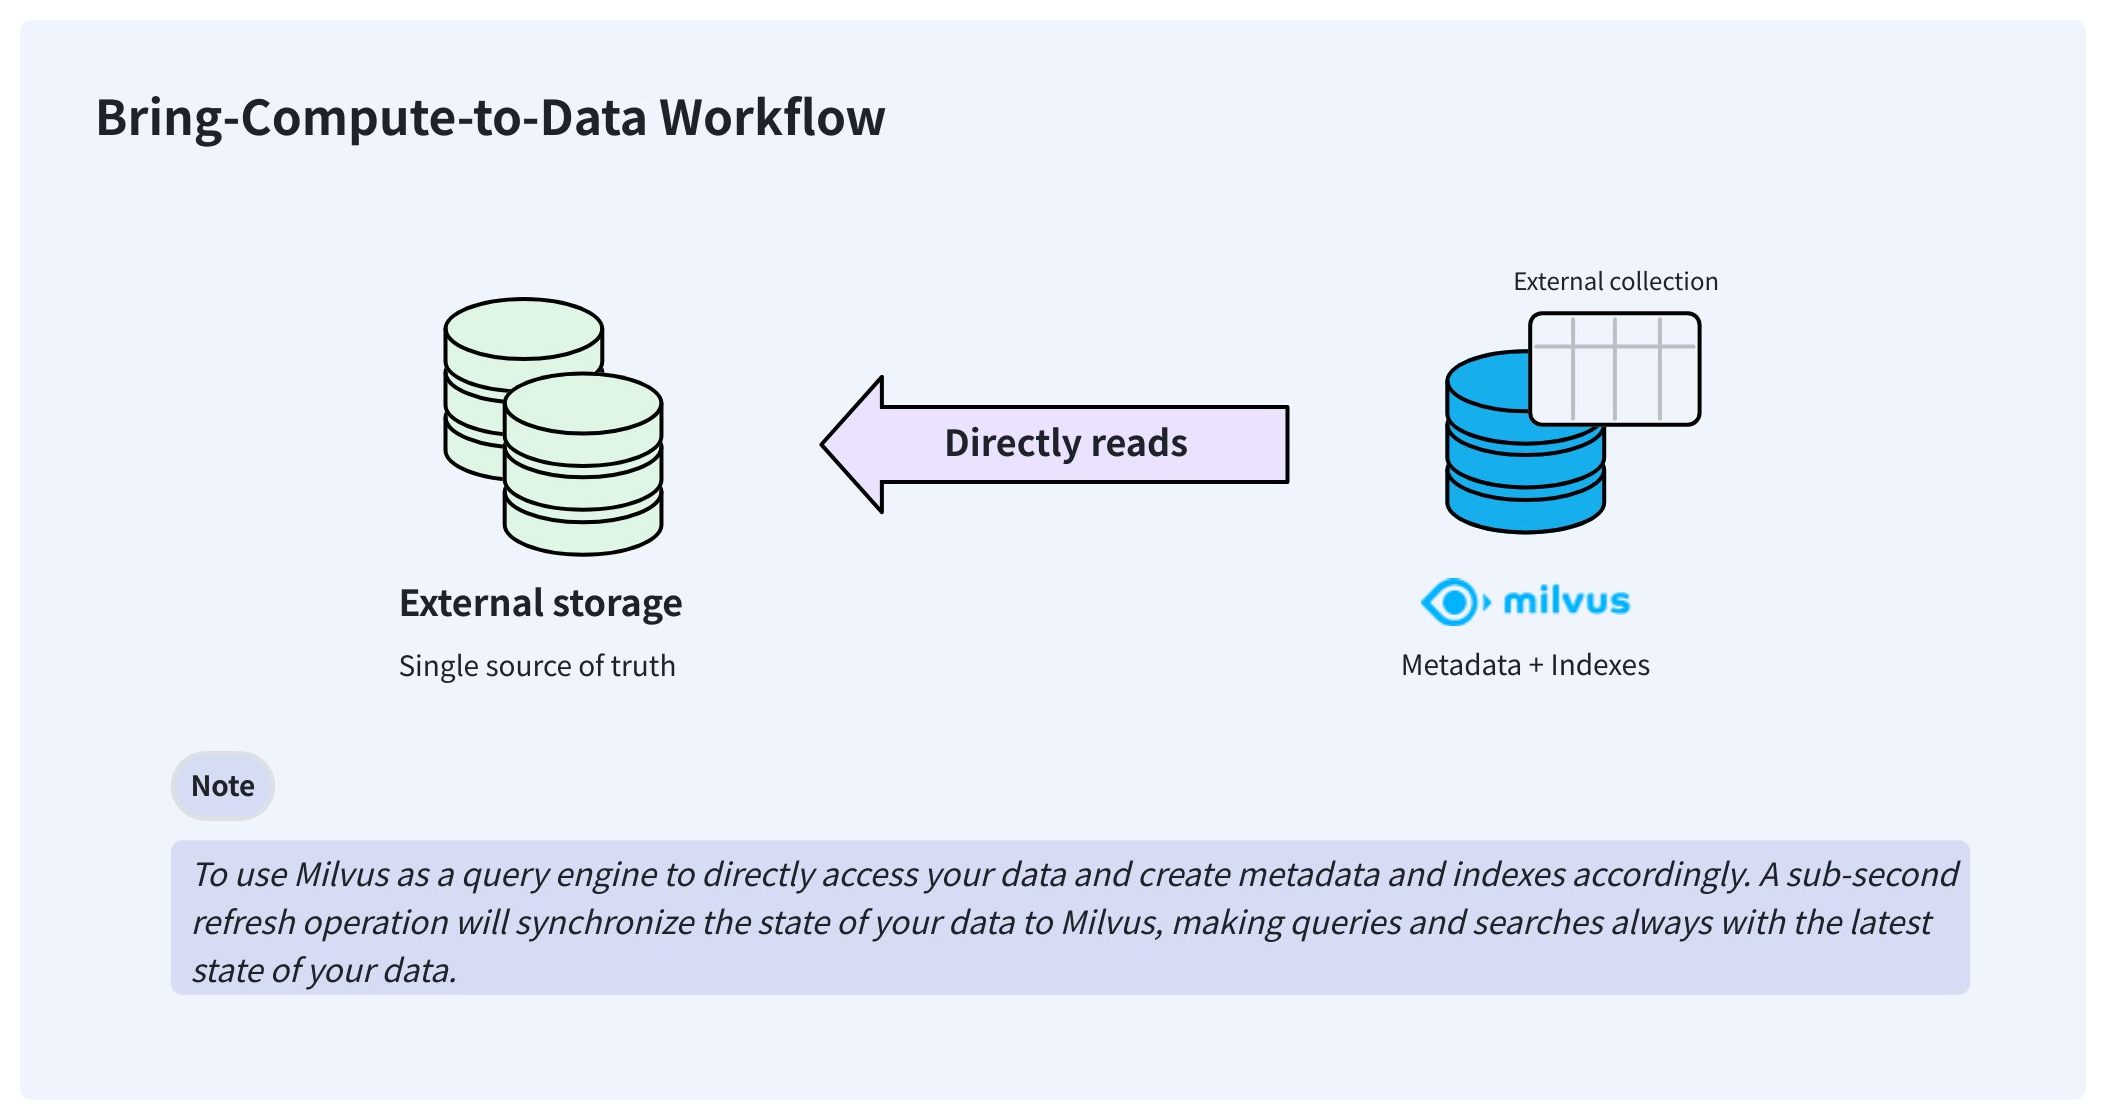 Flujo de trabajo «llevar el procesamiento a los datos »
Una vez creada, una colección externa puede acceder directamente a sus datos y mantenerlos en el mismo lugar donde los almacena. En segundo plano, Milvus crea archivos de manifiesto para registrar las correspondencias entre los metadatos de Milvus y las filas de los archivos de datos externos. Una vez que los archivos de manifiesto están listos, puede crear índices en la colección externa tal y como lo haría en cualquier colección gestionada.
Cuando tus datos cambian, al activar manualmente una actualización en menos de un segundo se actualizan los metadatos, lo que mantiene Milvus siempre al día.
Paso 1: Crear un esquema
Al igual que al crear una colección gestionada, también es necesario crear un esquema antes de crear una colección externa. Sin embargo, el esquema es ligeramente diferente al de una colección gestionada.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(
    external_source='s3://s3.<region-id>.amazonaws.com/<bucket>/',
    external_spec='{
        "format": "parquet",
        "extfs": {
            ...
        }
    }'
)
import com.google.gson.JsonObject;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

JsonObject externalSpec = new JsonObject();
externalSpec.addProperty("format", "parquet");
externalSpec.add("extfs", new JsonObject());

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .externalSource("s3://s3.<region-id>.amazonaws.com/<bucket>/")
        .externalSpec(externalSpec)
        .build();
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

schema := entity.NewSchema().
    WithName("product_embeddings").
    WithExternalSource("s3://my-bucket/embeddings/").
    WithExternalSpec(`{"format": "parquet", "extfs": { ... }}`)
// node
export fields='[
        {
            "fieldName": "product_id",
            "dataType": "Int64",
            "isPrimary": true
        },
        {
            "fieldName": "embedding",
            "dataType": "FloatVector",
            "elementTypeParams": {
                "dim": "768"
            }
        },
        {
            "fieldName": "product_name",
            "dataType": "VarChar",
            "elementTypeParams": {
                "max_length": 512
            }
        }
    ]'
Para crear el esquema de una colección externa, debes especificar el URI de los datos de origen, el formato de los datos y la configuración de autenticación.
Nombre del parámetro |
Descripción del parámetro |
Valor de ejemplo |
|---|---|---|
|
Formato de los archivos de datos de origen de destino. |
|
|
Un identificador de instantánea de tabla de Iceberg válido. Este parámetro solo se aplica cuando se establece « |
|
|
Configuración del sistema de archivos externo en una estructura JSON convertida a cadena. |
-- |
Dispones de las siguientes opciones para configurar los ajustes de autenticación:
Usar AWS AK/SK
Esta opción se aplica a MinIO autohospedado o al caso en el que dispongas de AK/SK para tu trabajo.
{
    "format": "...",
    "extfs": {
        "access_key_id":     "AKIA..",
        "access_key_value":  "u4Lh...",
        "region":            "us-west-2",
        "cloud_provider":    "aws",
        "use_ssl":           "true",
        "use_virtual_host":  "true"
    }
}
Nombre del parámetro |
Descripción del parámetro |
Valor de ejemplo |
|---|---|---|
|
ID de la clave de acceso |
|
|
Valor de la clave de acceso |
|
|
ID de la región en la nube |
|
|
ID del proveedor de la nube |
|
|
Si se utiliza SSL para establecer conexiones. |
|
|
Si se utiliza alojamiento virtual para acceder a su depósito. Para obtener más información, consulta este artículo. |
|
Utilizar AWS IAM
Esta opción se aplica al caso en el que Milvus se ejecuta en una instancia de EC2 o en un clúster de EKS. En este caso, no es necesario codificar de forma fija las claves AK/SK.
{
    "format": "...",
    "extfs": {
        "use_iam":           "true",
        "iam_endpoint":      "https://sts.<region>.amazonaws.com",
        "region":            "us-west-2",
        "cloud_provider":    "aws",
        "use_ssl":           "true"
    }
}
Nombre del parámetro |
Descripción del parámetro |
Valor de ejemplo |
|---|---|---|
|
Indica si se va a utilizar AWS IAM. Establezca este valor en « |
|
|
Un punto de conexión STS de AWS válido. Para obtener más información, consulta este artículo. |
|
|
ID de la región en la nube |
|
|
ID del proveedor de la nube |
|
|
Si se utiliza SSL para establecer conexiones. |
|
Usar credenciales globales de Milvus
Esta opción se aplica cuando se almacenan datos externos en el bucket de Milvus, y la configuración global de MinIO especificada en milvus.yaml se puede utilizar directamente para acceder a los datos.
{
    "format": "...",
    "extfs": {
        "storage_type": "remote"
    }
}
Usar el ARN del rol de IAM
Esta opción es aplicable cuando su organización utiliza diferentes cuentas de AWS para gestionar el clúster de Milvus y el depósito que contiene los archivos de datos de destino.
En este caso, el propietario del depósito debe crear un rol de IAM que
asigne
AmazonS3FullAccesso una política más detallada para el acceso al bucket.Incluya una «
sts:ExternalId» definida por el usuario en el campo «Condición» de la política de confianza del rol.
A continuación, el propietario del bucket deberá proporcionarte el ARN del rol de IAM y el ID externo para que puedas llamar a sts:AssumeRole con esos valores y asumir el rol de IAM.
A continuación se muestra un ejemplo de política de permisos que debe adjuntarse al rol de IAM con los permisos permitidos. Puede adaptarla a sus necesidades.
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Effect": "Allow",
            "Action": [
                "s3:ListBucket",
                "s3:GetBucketLocation"
            ],
            "Resource": "arn:aws:s3:::SOURCE-DATA-BUCKET"
        },
        {
            "Effect": "Allow",
            "Action": [
                "s3:GetObject",
                "s3:PutObject",
                "s3:DeleteObject"
            ],
            "Resource": "arn:aws:s3:::SOURCE-DATA-BUCKET/*"
        }
    ]
}
Además, la política de confianza asociada al rol de IAM define quién está autorizado a asumirlo.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "AWS": "arn:aws:iam::ACCOUNT_RUNNING_MILVUS:root"
      },
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": {
          "sts:ExternalId": "YOUR_UNIQUE_EXTERNAL_ID"
        }
      }
    }
  ]
}
Una vez que haya obtenido el ARN del rol de IAM y el ID externo, puede configurar el parámetro external_spec de la siguiente manera:
{
    "format": "...",
    "extfs": {
        "cloud_provider": "aws",
        "region": "us-west-2",
        "storage_type": "remote",
        "use_ssl": "true",
        "use_iam": "true",
        "role_arn": "arn:aws:iam::306787000000:role/lentitude-bucket-role",
        "external_id": "YOUR_UNIQUE_EXTERNAL_ID",
        "load_frequency": "900"
    }
}
Nombre del parámetro |
Descripción del parámetro |
Valor de ejemplo |
|---|---|---|
|
ID del proveedor de nube |
|
|
ID de la región en la nube |
|
|
Si se utiliza SSL para establecer conexiones. |
|
|
Si se utiliza AWS IAM. Establece este valor en « |
|
|
ARN del rol de IAM obtenido del propietario del depósito. |
|
|
ID externo obtenido del propietario del bucket. |
-- |
|
Intervalo, en segundos, en el que Milvus recupera las credenciales de autenticación temporales. |
|
Paso 2: Añadir campos
Una vez que el esquema esté listo, puedes añadir campos de la siguiente manera:
schema.add_field(
    field_name="product_id",
    datatype=DataType.INT64,
    external_field="id" # field name in the external data file
)
schema.add_field(
    field_name="product_name",
    datatype=DataType.VARCHAR,
    max_length=512,
    external_field="name"
)
schema.add_field(
    field_name="embedding",
    datatype=DataType.FLOAT_VECTOR,
    dim=768,
    external_field="vector"
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("product_id")
        .dataType(DataType.Int64)
        .externalField("id")
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("product_name")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .externalField("name")
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .externalField("vector")
        .build());
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

schema = schema.
    WithField(
        entity.NewField().
            WithName("product_id").
            WithDataType(entity.FieldTypeInt64).
            WithExternalField("id"),
    ).
    WithField(
        entity.NewField().
            WithName("product_name").
            WithDataType(entity.FieldTypeVarChar).
            WithMaxLength(512).
            WithExternalField("name"),
    ).
    WithField(
        entity.NewField().
            WithName("embedding").
            WithDataType(entity.FieldTypeFloatVector).
            WithDim(768).
            WithExternalField("vector"),
    )
// node
export schema="{
    \"externalSource\": \"volume://my_volume/path/to/a/folder\",
    \"externalSpec\": \"{\\\"format\\\": \\\"parquet\\\"}\",
    \"fields\": $fields
}"
Paso 3: Crear una colección
Tras añadir todos los campos al esquema, puedes crear la colección externa.
client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

client.create_collection(
    collection_name="test_collection",
    schema=schema
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

ConnectConfig connectConfig = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build();

MilvusClientV2 client = new MilvusClientV2(connectConfig);

CreateCollectionReq createReq = CreateCollectionReq.builder()
        .collectionName("test_collection")
        .collectionSchema(schema)
        .build();
client.createCollection(createReq);
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "http://localhost:19530"
token := "root:Milvus"

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
    APIKey: token
})

err = client.CreateCollection(ctx, milvusclient.NewCreateCollectionOption("test_collection", schema))

if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// node
curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"schema\": $schema
}"
Paso 4: Crear índices
Puedes crear índices para los campos de la colección externa igual que lo haces en las colecciones gestionadas.
index_params = client.prepare_index_params()
# Add indexes
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
index_params.add_index(
    field_name="product_name",
    index_type="AUTOINDEX"
)
client.create_index(
    db_name="my_database",
    collection_name="test_collection",
    index_params=index_params
)
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.index.request.CreateIndexReq;
import java.util.*;

IndexParam indexParamForIdField = IndexParam.builder()
        .fieldName("product_name")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .build();
IndexParam indexParamForVectorField = IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build();
List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForIdField);
indexParams.add(indexParamForVectorField);
CreateIndexReq createIndexReq = CreateIndexReq.builder()
        .dbName("my_database")
        .collectionName("test_collection")
        .indexParams(indexParams)
        .build();
client.createIndex(createIndexReq);
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

collectionName := "test_collection"
indexOptions := []milvusclient.CreateIndexOption{
    milvusclient.NewCreateIndexOption(collectionName, "embedding", index.NewAutoIndex(entity.COSINE)),
    milvusclient.NewCreateIndexOption(collectionName, "product_name", index.NewAutoIndex(index.AUTOINDEX)),
}
indexTask, err := client.CreateIndex(ctx, indexOptions)
if err != nil {
    // handler err
}
err = indexTask.Await(ctx)
if err != nil {
    // handler err
}
client.createIndex({
    db_name: "my_database",
    collection_name: "test_collection",
    field_name: "product_name",
    index_type: "AUTOINDEX"
})
client.createIndex({
    db_name: "my_database",
    collection_name: "test_collection",
    field_name: "embedding",
    index_type: "AUTOINDEX",
    metric_type: "COSINE"
})
export indexParams='[
        {
            "fieldName": "embedding",
            "indexName": "my_vector",
            "indexType": "AUTOINDEX"
        },
        {
            "fieldName": "product_name",
            "indexName": "my_id",
            "indexType": "AUTOINDEX"
        }
    ]'

curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/indexes/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"indexParams\": $indexParams
}"
Paso 5: Actualizar los datos
Una vez que la colección esté lista, actualízala para crear los metadatos y los índices de tus datos.
job_id = client.refresh_external_collection(
    db_name="my_database",
    collection_name="test_collection"
)
while True:
    progress = client.get_refresh_external_collection_progress(job_id=job_id)
    print(f"  {progress.state}: {progress.progress}%")
    if progress.state == "RefreshCompleted":
        elapsed = progress.end_time - progress.start_time
        print(f"  Completed in {elapsed}ms")
        break
    elif progress.state == "RefreshFailed":
        print(f"  Failed: {progress.reason}")
        break
    time.sleep(2)
import io.milvus.v2.service.utility.request.GetRefreshExternalCollectionProgressReq;
import io.milvus.v2.service.utility.request.ListRefreshExternalCollectionJobsReq;
import io.milvus.v2.service.utility.request.RefreshExternalCollectionReq;
import io.milvus.v2.service.utility.response.GetRefreshExternalCollectionProgressResp;
import io.milvus.v2.service.utility.response.ListRefreshExternalCollectionJobsResp;
import io.milvus.v2.service.utility.response.RefreshExternalCollectionJobInfo;
import io.milvus.v2.service.utility.response.RefreshExternalCollectionResp;

while (true) {
    GetRefreshExternalCollectionProgressResp resp = client.getRefreshExternalCollectionProgress(
            GetRefreshExternalCollectionProgressReq.builder()
                    .jobId(jobId)
                    .build());
    RefreshExternalCollectionJobInfo jobInfo = resp.getJobInfo();
    if ("RefreshCompleted".equals(jobInfo.getState())) {
        long elapsed = jobInfo.getEndTime() - jobInfo.getStartTime();
        System.out.printf("  Refresh completed in %dms%n", elapsed);
        break;
    } else if ("RefreshFailed".equals(jobInfo.getState())) {
        System.out.printf("  Refresh failed: %s%n", jobInfo.getReason());
    }
    TimeUnit.SECONDS.sleep(2);
}
refreshResult, err := client.RefreshExternalCollection(ctx,
    client.NewRefreshExternalCollectionOption("test_collection"))
jobID := refreshResult.JobID
for {
    progress, _ := client.GetRefreshExternalCollectionProgress(ctx,
        client.NewGetRefreshExternalCollectionProgressOption(jobID))
    fmt.Printf("State: %s\n", progress.State)
    if progress.State == entity.RefreshStateCompleted {
        fmt.Println("Refresh completed!")
        break
    }
    if progress.State == entity.RefreshStateFailed {
        fmt.Printf("Refresh failed: %s\n", progress.Reason)
        break
    }
    time.Sleep(2 * time.Second)
}
// node
curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/jobs/external_collection/refresh" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"externalSource\": \"volume://my_volume/path/to/a/folder\",
    \"externalSpec\": \"{\\\"format\\\": \\\"parquet\\\"}\"
}"
La operación de actualización es asíncrona, por lo que debes configurar un bucle para supervisar su progreso.
La operación de actualización analiza los metadatos de los archivos de datos y genera los archivos de manifiesto en consecuencia. Suele tardar entre 150 y 250 ms.
Los archivos de manifiesto registran la correspondencia entre los metadatos de Milvus y las filas de los archivos externos.
Si se produce una actualización de tus datos de origen, debes volver a llamar manualmente a la operación de actualización para mantener Milvus al día.
Una actualización que requiera eliminar todos los metadatos activos sin realizar ninguna inserción dará lugar a un error.
Próximos pasos
Una vez que haya actualizado la colección externa, puede cargarla y liberarla, así como realizar búsquedas de similitud y consultas en la colección externa tal y como lo haría en cualquier colección gestionada, salvo que las colecciones de una base de datos para computación bajo demanda deben estar asociadas a un clúster bajo demanda para poder realizar búsquedas y consultas.
Antes de realizar operaciones DQL, como búsquedas, consultas, operaciones «get» y búsquedas híbridas, debe crear una sesión para asociar los recursos de computación de un clúster bajo demanda.
Si posteriormente la fuente de datos externa contiene otro campo que desee exponer en Milvus, añada un campo al esquema de la colección externa y actualice de nuevo la colección externa. Para obtener más información, consulte «Modificar el esquema de una colección externa».
