

Externe Sammlung erstellenCompatible with Milvus 3.0.x
Eine externe Sammlung ist eine Art der Datensammlung in Milvus, die auf Daten aus externen Speichersystemen oder Datenbanktabellen wie AWS S3 und Iceberg zugreift, ohne diese in Milvus zu kopieren. Sie fungiert als Abfrageebene über Data Lakes und gewährleistet gleichzeitig die Kompatibilität mit den Abfrage-Schnittstellen von Milvus.
Für diese Funktion ist Storage V3 erforderlich. Anweisungen zur Aktivierung und Hinweise zur Kompatibilität finden Sie unter Storage V3.
Übersicht
In einer typischen KI-Datenpipeline haben Nutzer ihre Daten möglicherweise bereits im Parquet-Format oder anderen Formaten auf ihrem Speichersystem, wie z. B. AWS S3, gespeichert. Damit Milvus diese extern gespeicherten Daten verarbeiten kann, müssen Nutzer sie in der Regel mithilfe von ETL-Pipelines (Extract-Transform-Load) in den Milvus-eigenen Speicher importieren.
Dieser „Bring-your-Data-to-Milvus“-Workflow erzeugt redundante Daten, die schwer zu synchronisieren sind, und erhöht den Wartungsaufwand für die Techniker, um die Datenkonsistenz sicherzustellen.
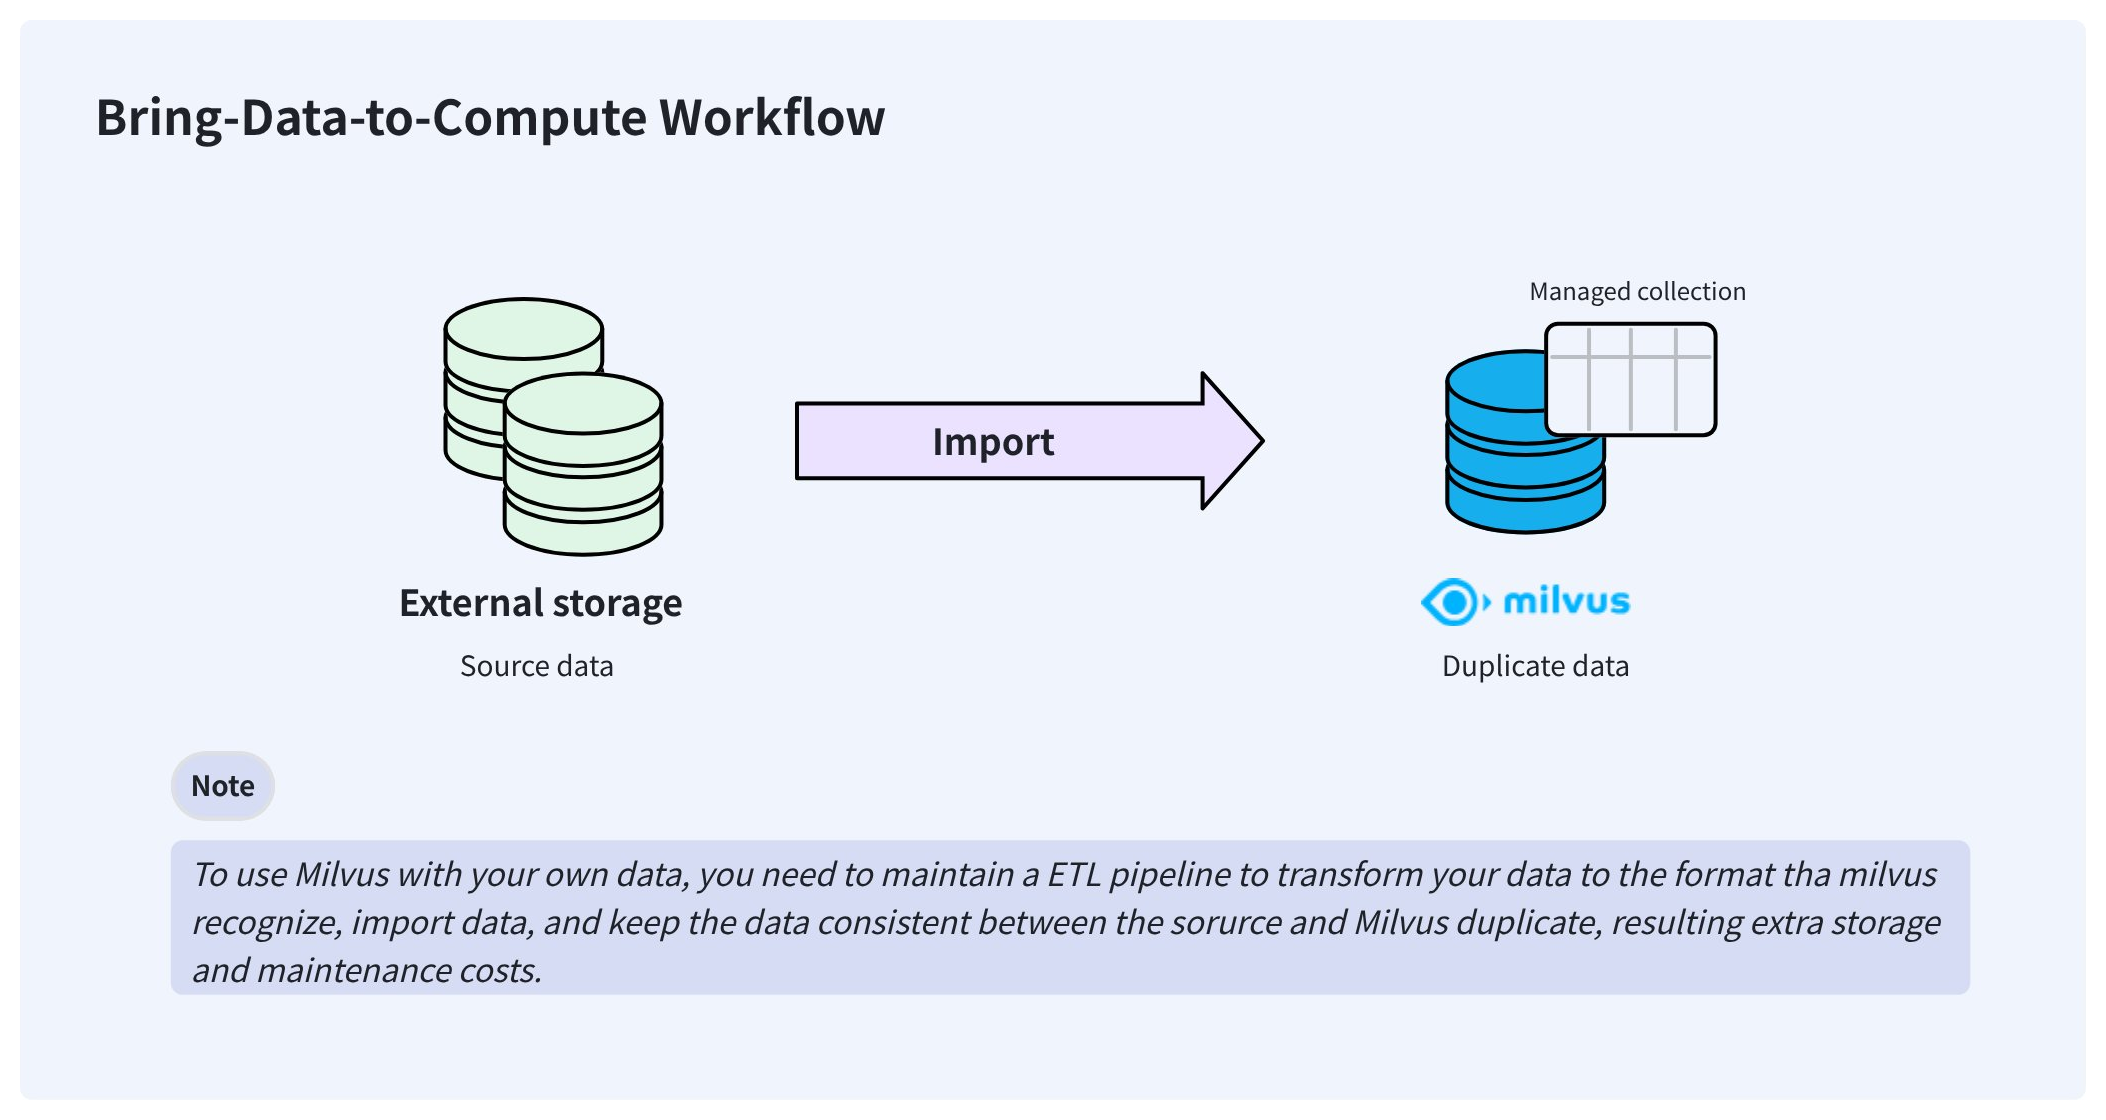 Workflow „Daten zur Verarbeitung bringen “
Um diese Probleme zu lösen, bietet Milvus externe Sammlungen an, mit denen Sie von Milvus aus auf Ihre extern gespeicherten Daten zugreifen können, ohne sich um Datensynchronisation und ETL-Pipelines kümmern zu müssen.
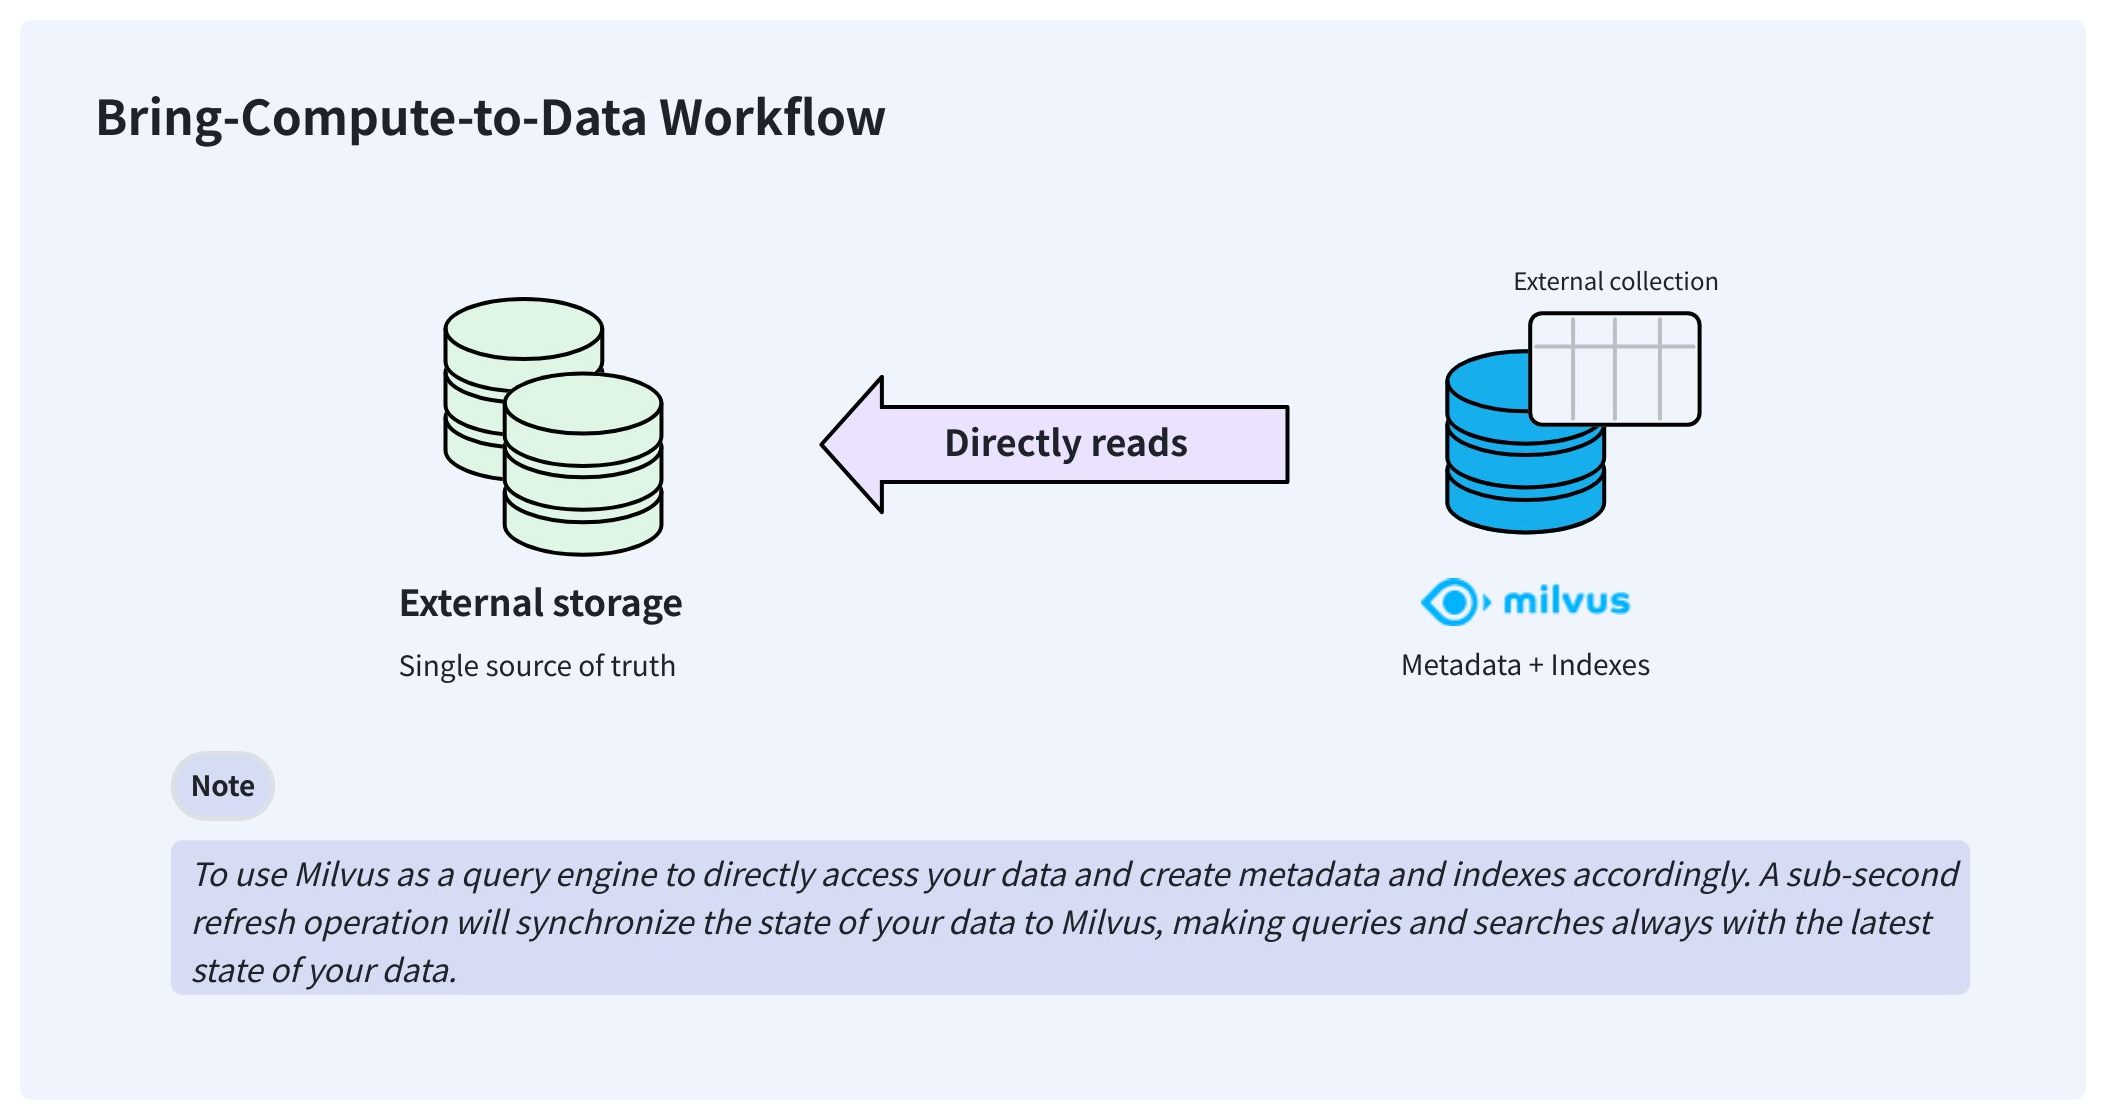 „Rechenleistung zu den Daten bringen“-Workflow
Sobald eine externe Sammlung erstellt ist, kann sie direkt auf Ihre Daten zugreifen und diese an demselben Ort belassen, an dem Sie sie speichern. Im Hintergrund erstellt Milvus Manifestdateien, um die Zuordnungen zwischen den Milvus-Metadaten und den Zeilen in externen Datendateien zu erfassen. Sobald die Manifestdateien bereitstehen, können Sie in der externen Sammlung Indizes erstellen, genau wie in jeder verwalteten Sammlung.
Wenn sich Ihre Daten ändern, werden die Metadaten durch manuelles Auslösen einer Aktualisierung innerhalb von weniger als einer Sekunde aktualisiert, sodass Milvus stets auf dem neuesten Stand bleibt.
Schritt 1: Schema erstellen
Genau wie beim Erstellen einer verwalteten Sammlung müssen Sie auch vor dem Erstellen einer externen Sammlung ein Schema erstellen. Das Schema unterscheidet sich jedoch geringfügig von dem einer verwalteten Sammlung.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(
    external_source='s3://s3.<region-id>.amazonaws.com/<bucket>/',
    external_spec='{
        "format": "parquet",
        "extfs": {
            ...
        }
    }'
)
import com.google.gson.JsonObject;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

JsonObject externalSpec = new JsonObject();
externalSpec.addProperty("format", "parquet");
externalSpec.add("extfs", new JsonObject());

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .externalSource("s3://s3.<region-id>.amazonaws.com/<bucket>/")
        .externalSpec(externalSpec)
        .build();
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

schema := entity.NewSchema().
    WithName("product_embeddings").
    WithExternalSource("s3://my-bucket/embeddings/").
    WithExternalSpec(`{"format": "parquet", "extfs": { ... }}`)
// node
export fields='[
        {
            "fieldName": "product_id",
            "dataType": "Int64",
            "isPrimary": true
        },
        {
            "fieldName": "embedding",
            "dataType": "FloatVector",
            "elementTypeParams": {
                "dim": "768"
            }
        },
        {
            "fieldName": "product_name",
            "dataType": "VarChar",
            "elementTypeParams": {
                "max_length": 512
            }
        }
    ]'
Um das Schema für eine externe Sammlung zu erstellen, müssen Sie die URI der Quelldaten, das Datenformat und die Authentifizierungseinstellungen angeben.
Parametername |
Parameterbeschreibung |
Beispielwert |
|---|---|---|
|
Format der Quelldatendateien des Ziels. |
|
|
Eine gültige Iceberg-Tabellen-Snapshot-ID. Dieser Parameter gilt nur, wenn Sie „ |
|
|
Einstellungen für das externe Dateisystem in einer als Zeichenkette dargestellten JSON-Struktur. |
-- |
Sie haben folgende Möglichkeiten, die Authentifizierungseinstellungen festzulegen:
AWS AK/SK verwenden
Diese Option gilt für selbst gehostetes MinIO oder für den Fall, dass Sie über AK/SK für Ihre Arbeit verfügen.
{
    "format": "...",
    "extfs": {
        "access_key_id":     "AKIA..",
        "access_key_value":  "u4Lh...",
        "region":            "us-west-2",
        "cloud_provider":    "aws",
        "use_ssl":           "true",
        "use_virtual_host":  "true"
    }
}
Parametername |
Parameterbeschreibung |
Beispielwert |
|---|---|---|
|
Zugriffsschlüssel-ID |
|
|
Wert des Zugriffsschlüssels |
|
|
Cloud-Region-ID |
|
|
Cloud-Anbieter-ID |
|
|
Ob SSL zum Aufbau von Verbindungen verwendet wird. |
|
|
Ob für den Zugriff auf Ihren Bucket virtuelles Hosting verwendet werden soll. Weitere Informationen finden Sie in diesem Artikel. |
|
AWS IAM verwenden
Diese Option gilt für das Szenario, in dem Milvus auf einer EC2-Instanz oder einem EKS-Cluster ausgeführt wird. In diesem Fall müssen Sie die AK/SK nicht fest codieren.
{
    "format": "...",
    "extfs": {
        "use_iam":           "true",
        "iam_endpoint":      "https://sts.<region>.amazonaws.com",
        "region":            "us-west-2",
        "cloud_provider":    "aws",
        "use_ssl":           "true"
    }
}
Parametername |
Parameterbeschreibung |
Beispielwert |
|---|---|---|
|
Gibt an, ob AWS IAM verwendet werden soll. Setzen Sie diesen Wert für diese Option auf „ |
|
|
Ein gültiger AWS-STS-Endpunkt. Weitere Informationen finden Sie in diesem Artikel. |
|
|
Cloud-Regions-ID |
|
|
Cloud-Anbieter-ID |
|
|
Gibt an, ob SSL zum Aufbau von Verbindungen verwendet wird. |
|
Globale Milvus-Anmeldedaten verwenden
Diese Option gilt, wenn Sie externe Daten im Milvus-Bucket speichern und die unter milvus.yaml angegebenen globalen MinIO-Einstellungen direkt für den Zugriff auf die Daten verwendet werden können.
{
    "format": "...",
    "extfs": {
        "storage_type": "remote"
    }
}
IAM-Rollen-ARN verwenden
Diese Option gilt, wenn Ihre Organisation verschiedene AWS-Konten zur Verwaltung des Milvus-Clusters und des Buckets verwendet, in dem die Zieldatendateien gespeichert sind.
In diesem Fall sollte der Bucket-Eigentümer eine IAM-Rolle erstellen, die
AmazonS3FullAccessoder eine detailliertere Richtlinie für den Bucket-Zugriff zuweist.eine selbst definierte „
sts:ExternalId“ im Feld „Condition“ der Trust-Richtlinie der Rolle enthält.
Anschließend sollte der Bucket-Eigentümer Ihnen die IAM-Rollen-ARN und die externe ID zur Verfügung stellen, damit Sie mit diesen Werten „ sts:AssumeRole “ aufrufen können, um die IAM-Rolle zu übernehmen.
Im Folgenden finden Sie ein Beispiel für eine Berechtigungsrichtlinie, die der IAM-Rolle mit den zulässigen Berechtigungen zugeordnet werden soll. Sie können diese an Ihre Anforderungen anpassen.
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Effect": "Allow",
            "Action": [
                "s3:ListBucket",
                "s3:GetBucketLocation"
            ],
            "Resource": "arn:aws:s3:::SOURCE-DATA-BUCKET"
        },
        {
            "Effect": "Allow",
            "Action": [
                "s3:GetObject",
                "s3:PutObject",
                "s3:DeleteObject"
            ],
            "Resource": "arn:aws:s3:::SOURCE-DATA-BUCKET/*"
        }
    ]
}
Die mit der IAM-Rolle verknüpfte Vertrauensrichtlinie legt fest, wer diese Rolle annehmen darf.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "AWS": "arn:aws:iam::ACCOUNT_RUNNING_MILVUS:root"
      },
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": {
          "sts:ExternalId": "YOUR_UNIQUE_EXTERNAL_ID"
        }
      }
    }
  ]
}
Sobald Sie die IAM-Rollen-ARN und die externe ID erhalten haben, können Sie den Parameter „ external_spec “ wie folgt einrichten:
{
    "format": "...",
    "extfs": {
        "cloud_provider": "aws",
        "region": "us-west-2",
        "storage_type": "remote",
        "use_ssl": "true",
        "use_iam": "true",
        "role_arn": "arn:aws:iam::306787000000:role/lentitude-bucket-role",
        "external_id": "YOUR_UNIQUE_EXTERNAL_ID",
        "load_frequency": "900"
    }
}
Parametername |
Parameterbeschreibung |
Beispielwert |
|---|---|---|
|
Cloud-Anbieter-ID |
|
|
Cloud-Region-ID |
|
|
Gibt an, ob SSL zum Aufbau von Verbindungen verwendet wird. |
|
|
Ob AWS IAM verwendet werden soll. Setzen Sie diese Option auf „ |
|
|
IAM-Rollen-ARN, die vom Bucket-Besitzer bereitgestellt wurde. |
|
|
Externe ID, die vom Bucket-Besitzer bereitgestellt wurde. |
-- |
|
Intervall in Sekunden, in dem Milvus temporäre Authentifizierungsdaten abruft. |
|
Schritt 2: Felder hinzufügen
Sobald das Schema fertig ist, können Sie wie folgt Felder hinzufügen:
schema.add_field(
    field_name="product_id",
    datatype=DataType.INT64,
    external_field="id" # field name in the external data file
)
schema.add_field(
    field_name="product_name",
    datatype=DataType.VARCHAR,
    max_length=512,
    external_field="name"
)
schema.add_field(
    field_name="embedding",
    datatype=DataType.FLOAT_VECTOR,
    dim=768,
    external_field="vector"
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("product_id")
        .dataType(DataType.Int64)
        .externalField("id")
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("product_name")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .externalField("name")
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .externalField("vector")
        .build());
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

schema = schema.
    WithField(
        entity.NewField().
            WithName("product_id").
            WithDataType(entity.FieldTypeInt64).
            WithExternalField("id"),
    ).
    WithField(
        entity.NewField().
            WithName("product_name").
            WithDataType(entity.FieldTypeVarChar).
            WithMaxLength(512).
            WithExternalField("name"),
    ).
    WithField(
        entity.NewField().
            WithName("embedding").
            WithDataType(entity.FieldTypeFloatVector).
            WithDim(768).
            WithExternalField("vector"),
    )
// node
export schema="{
    \"externalSource\": \"volume://my_volume/path/to/a/folder\",
    \"externalSpec\": \"{\\\"format\\\": \\\"parquet\\\"}\",
    \"fields\": $fields
}"
Schritt 3: Erstellen einer Sammlung
Nachdem Sie alle Felder zum Schema hinzugefügt haben, können Sie die externe Sammlung erstellen.
client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

client.create_collection(
    collection_name="test_collection",
    schema=schema
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

ConnectConfig connectConfig = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build();

MilvusClientV2 client = new MilvusClientV2(connectConfig);

CreateCollectionReq createReq = CreateCollectionReq.builder()
        .collectionName("test_collection")
        .collectionSchema(schema)
        .build();
client.createCollection(createReq);
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    client "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "http://localhost:19530"
token := "root:Milvus"

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
    APIKey: token
})

err = client.CreateCollection(ctx, milvusclient.NewCreateCollectionOption("test_collection", schema))

if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// node
curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"schema\": $schema
}"
Schritt 4: Indizes erstellen
Sie können Indizes für Felder externer Sammlungen genauso erstellen wie bei verwalteten Sammlungen.
index_params = client.prepare_index_params()
# Add indexes
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
index_params.add_index(
    field_name="product_name",
    index_type="AUTOINDEX"
)
client.create_index(
    db_name="my_database",
    collection_name="test_collection",
    index_params=index_params
)
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.index.request.CreateIndexReq;
import java.util.*;

IndexParam indexParamForIdField = IndexParam.builder()
        .fieldName("product_name")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .build();
IndexParam indexParamForVectorField = IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build();
List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForIdField);
indexParams.add(indexParamForVectorField);
CreateIndexReq createIndexReq = CreateIndexReq.builder()
        .dbName("my_database")
        .collectionName("test_collection")
        .indexParams(indexParams)
        .build();
client.createIndex(createIndexReq);
import (
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

collectionName := "test_collection"
indexOptions := []milvusclient.CreateIndexOption{
    milvusclient.NewCreateIndexOption(collectionName, "embedding", index.NewAutoIndex(entity.COSINE)),
    milvusclient.NewCreateIndexOption(collectionName, "product_name", index.NewAutoIndex(index.AUTOINDEX)),
}
indexTask, err := client.CreateIndex(ctx, indexOptions)
if err != nil {
    // handler err
}
err = indexTask.Await(ctx)
if err != nil {
    // handler err
}
client.createIndex({
    db_name: "my_database",
    collection_name: "test_collection",
    field_name: "product_name",
    index_type: "AUTOINDEX"
})
client.createIndex({
    db_name: "my_database",
    collection_name: "test_collection",
    field_name: "embedding",
    index_type: "AUTOINDEX",
    metric_type: "COSINE"
})
export indexParams='[
        {
            "fieldName": "embedding",
            "indexName": "my_vector",
            "indexType": "AUTOINDEX"
        },
        {
            "fieldName": "product_name",
            "indexName": "my_id",
            "indexType": "AUTOINDEX"
        }
    ]'

curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/indexes/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"indexParams\": $indexParams
}"
Schritt 5: Daten aktualisieren
Sobald die Sammlung bereit ist, aktualisieren Sie sie, um die Metadaten und Indizes für Ihre Daten zu erstellen.
job_id = client.refresh_external_collection(
    db_name="my_database",
    collection_name="test_collection"
)
while True:
    progress = client.get_refresh_external_collection_progress(job_id=job_id)
    print(f"  {progress.state}: {progress.progress}%")
    if progress.state == "RefreshCompleted":
        elapsed = progress.end_time - progress.start_time
        print(f"  Completed in {elapsed}ms")
        break
    elif progress.state == "RefreshFailed":
        print(f"  Failed: {progress.reason}")
        break
    time.sleep(2)
import io.milvus.v2.service.utility.request.GetRefreshExternalCollectionProgressReq;
import io.milvus.v2.service.utility.request.ListRefreshExternalCollectionJobsReq;
import io.milvus.v2.service.utility.request.RefreshExternalCollectionReq;
import io.milvus.v2.service.utility.response.GetRefreshExternalCollectionProgressResp;
import io.milvus.v2.service.utility.response.ListRefreshExternalCollectionJobsResp;
import io.milvus.v2.service.utility.response.RefreshExternalCollectionJobInfo;
import io.milvus.v2.service.utility.response.RefreshExternalCollectionResp;

while (true) {
    GetRefreshExternalCollectionProgressResp resp = client.getRefreshExternalCollectionProgress(
            GetRefreshExternalCollectionProgressReq.builder()
                    .jobId(jobId)
                    .build());
    RefreshExternalCollectionJobInfo jobInfo = resp.getJobInfo();
    if ("RefreshCompleted".equals(jobInfo.getState())) {
        long elapsed = jobInfo.getEndTime() - jobInfo.getStartTime();
        System.out.printf("  Refresh completed in %dms%n", elapsed);
        break;
    } else if ("RefreshFailed".equals(jobInfo.getState())) {
        System.out.printf("  Refresh failed: %s%n", jobInfo.getReason());
    }
    TimeUnit.SECONDS.sleep(2);
}
refreshResult, err := client.RefreshExternalCollection(ctx,
    client.NewRefreshExternalCollectionOption("test_collection"))
jobID := refreshResult.JobID
for {
    progress, _ := client.GetRefreshExternalCollectionProgress(ctx,
        client.NewGetRefreshExternalCollectionProgressOption(jobID))
    fmt.Printf("State: %s\n", progress.State)
    if progress.State == entity.RefreshStateCompleted {
        fmt.Println("Refresh completed!")
        break
    }
    if progress.State == entity.RefreshStateFailed {
        fmt.Printf("Refresh failed: %s\n", progress.Reason)
        break
    }
    time.Sleep(2 * time.Second)
}
// node
curl --request POST \
--url "${PROJECT_ENDPOINT}/v2/vectordb/jobs/external_collection/refresh" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"dbName\": \"my_database\",
    \"collectionName\": \"test_collection\",
    \"externalSource\": \"volume://my_volume/path/to/a/folder\",
    \"externalSpec\": \"{\\\"format\\\": \\\"parquet\\\"}\"
}"
Der Aktualisierungsvorgang läuft asynchron ab, daher müssen Sie eine Schleife einrichten, um den Fortschritt zu überwachen.
Der Aktualisierungsvorgang scannt die Metadaten der Datendateien und generiert entsprechend die Manifestdateien. Dies dauert in der Regel 150–250 ms.
Die Manifestdateien dokumentieren die Zuordnung zwischen den Metadaten in Milvus und den Zeilen in externen Dateien.
Wenn Ihre Quelldaten aktualisiert werden, müssen Sie den Aktualisierungsvorgang manuell erneut aufrufen, um Milvus auf dem neuesten Stand zu halten.
Eine Aktualisierung, bei der alle aktiven Metadaten entfernt werden müssen, ohne dass neue Einträge hinzugefügt werden, führt zu einer Ablehnung.
Nächste Schritte
Nachdem Sie die externe Sammlung aktualisiert haben, können Sie die Sammlung laden und freigeben sowie Ähnlichkeitssuchen und Abfragen in der externen Sammlung durchführen, wie Sie es bei jeder verwalteten Sammlung tun würden – mit der Ausnahme, dass Sammlungen in einer Datenbank für On-Demand-Computing für Suchvorgänge und Abfragen an einen On-Demand-Cluster angehängt werden müssen.
Bevor Sie DQL-Operationen wie Suche, Abfrage, Abruf und hybride Suche durchführen, müssen Sie eine Sitzung erstellen, um die Rechenressourcen eines On-Demand-Clusters zuzuweisen.
Falls die externe Datenquelle später ein weiteres Feld enthält, das Sie in Milvus verfügbar machen möchten, fügen Sie dem Schema der externen Sammlung ein Feld hinzu und aktualisieren Sie die externe Sammlung erneut. Weitere Informationen finden Sie unter „Schema der externen Sammlung ändern“.
