

نظرة عامة على وظيفة التضمينCompatible with Milvus 2.6.x
تتيح لك وحدة الوظائف في Milvus تحويل البيانات النصية الأولية إلى تضمينات متجهة من خلال الاستدعاء التلقائي لمزودي خدمات التضمين الخارجيين (مثل OpenAI و AWS Bedrock و Google Vertex AI، إلخ). بفضل وحدة الوظائف، لم تعد بحاجة إلى التفاعل يدويًا مع واجهات برمجة تطبيقات (API) التضمين — حيث يتولى Milvus العملية بأكملها المتمثلة في إرسال الطلبات إلى مزودي الخدمة، واستلام التضمينات، وتخزينها في مجموعاتك. بالنسبة للبحث الدلالي، ما عليك سوى توفير بيانات الاستعلام الأولية، وليس متجه الاستعلام. يقوم Milvus بإنشاء متجه الاستعلام باستخدام نفس النموذج الذي استخدمته للاستيعاب، ومقارنته بالمتجهات المخزنة، وإرجاع النتائج الأكثر صلة.
القيود
يجب أن يحتوي أي حقل إدخال تقوم وحدة Function بتضمينه دائمًا على قيمة؛ فإذا تم توفير قيمة فارغة، فستقوم الوحدة بإصدار خطأ.
تقوم وحدة Function بمعالجة الحقول المحددة صراحةً في مخطط المجموعة فقط؛ ولا تقوم بإنشاء تضمينات للحقول الديناميكية.
يجب أن تكون حقول الإدخال المراد تضمينها من النوع «
VARCHAR».يمكن لوحدة «Function» تضمين حقل إدخال إلى:
FLOAT_VECTORINT8_VECTOR
لا يتم دعم التحويلات إلى
BINARY_VECTORأوFLOAT16_VECTORأوBFLOAT16_VECTOR.
مزودي خدمات التضمين المدعومون
المزود |
النماذج النموذجية |
نوع التضمين |
طريقة المصادقة |
|---|---|---|---|
text-embedding-3-* |
|
مفتاح API |
|
قائم على النشر |
|
مفتاح واجهة برمجة التطبيقات |
|
text-embedding-v3 |
|
مفتاح واجهة برمجة التطبيقات |
|
amazon.titan-embed-text-v2 |
|
زوج AK/SK |
|
text-embedding-005 |
|
بيانات اعتماد حساب خدمة GCP بتنسيق JSON |
|
voyage-3، voyage-lite-02 |
|
مفتاح API |
|
embed-english-v3.0 |
|
مفتاح واجهة برمجة التطبيقات |
|
BAAI/bge-large-zh-v1.5 |
|
مفتاح API |
|
أي نموذج مدعوم بـ TEI |
|
مفتاح API اختياري |
|
النماذج التي يتم تقديمها عبر |
|
مفتاح API |
كيفية العمل
يوضح الرسم البياني التالي كيفية عمل الوظيفة في Milvus.
النص المدخل: يقوم المستخدمون بإدخال البيانات الأولية (مثل المستندات) إلى Milvus.
إنشاء التضمينات: تقوم وحدة الوظيفة داخل Milvus تلقائيًا باستدعاء مزود النموذج المُهيأ لتحويل البيانات الأولية إلى تضمينات متجهة.
تخزين التضمينات: يتم تخزين التضمينات الناتجة في حقول متجهة محددة بشكل صريح داخل مجموعات Milvus.
نص الاستعلام: يقوم المستخدمون بإرسال استعلامات نصية إلى Milvus.
البحث الدلالي: يقوم Milvus داخليًّا بتحويل الاستعلامات إلى تضمينات متجهة، ويجري عمليات بحث عن التشابه مقابل التضمينات المخزنة، ويسترد النتائج ذات الصلة.
إرجاع النتائج: يعرض Milvus النتائج الأكثر مطابقة للتطبيق.
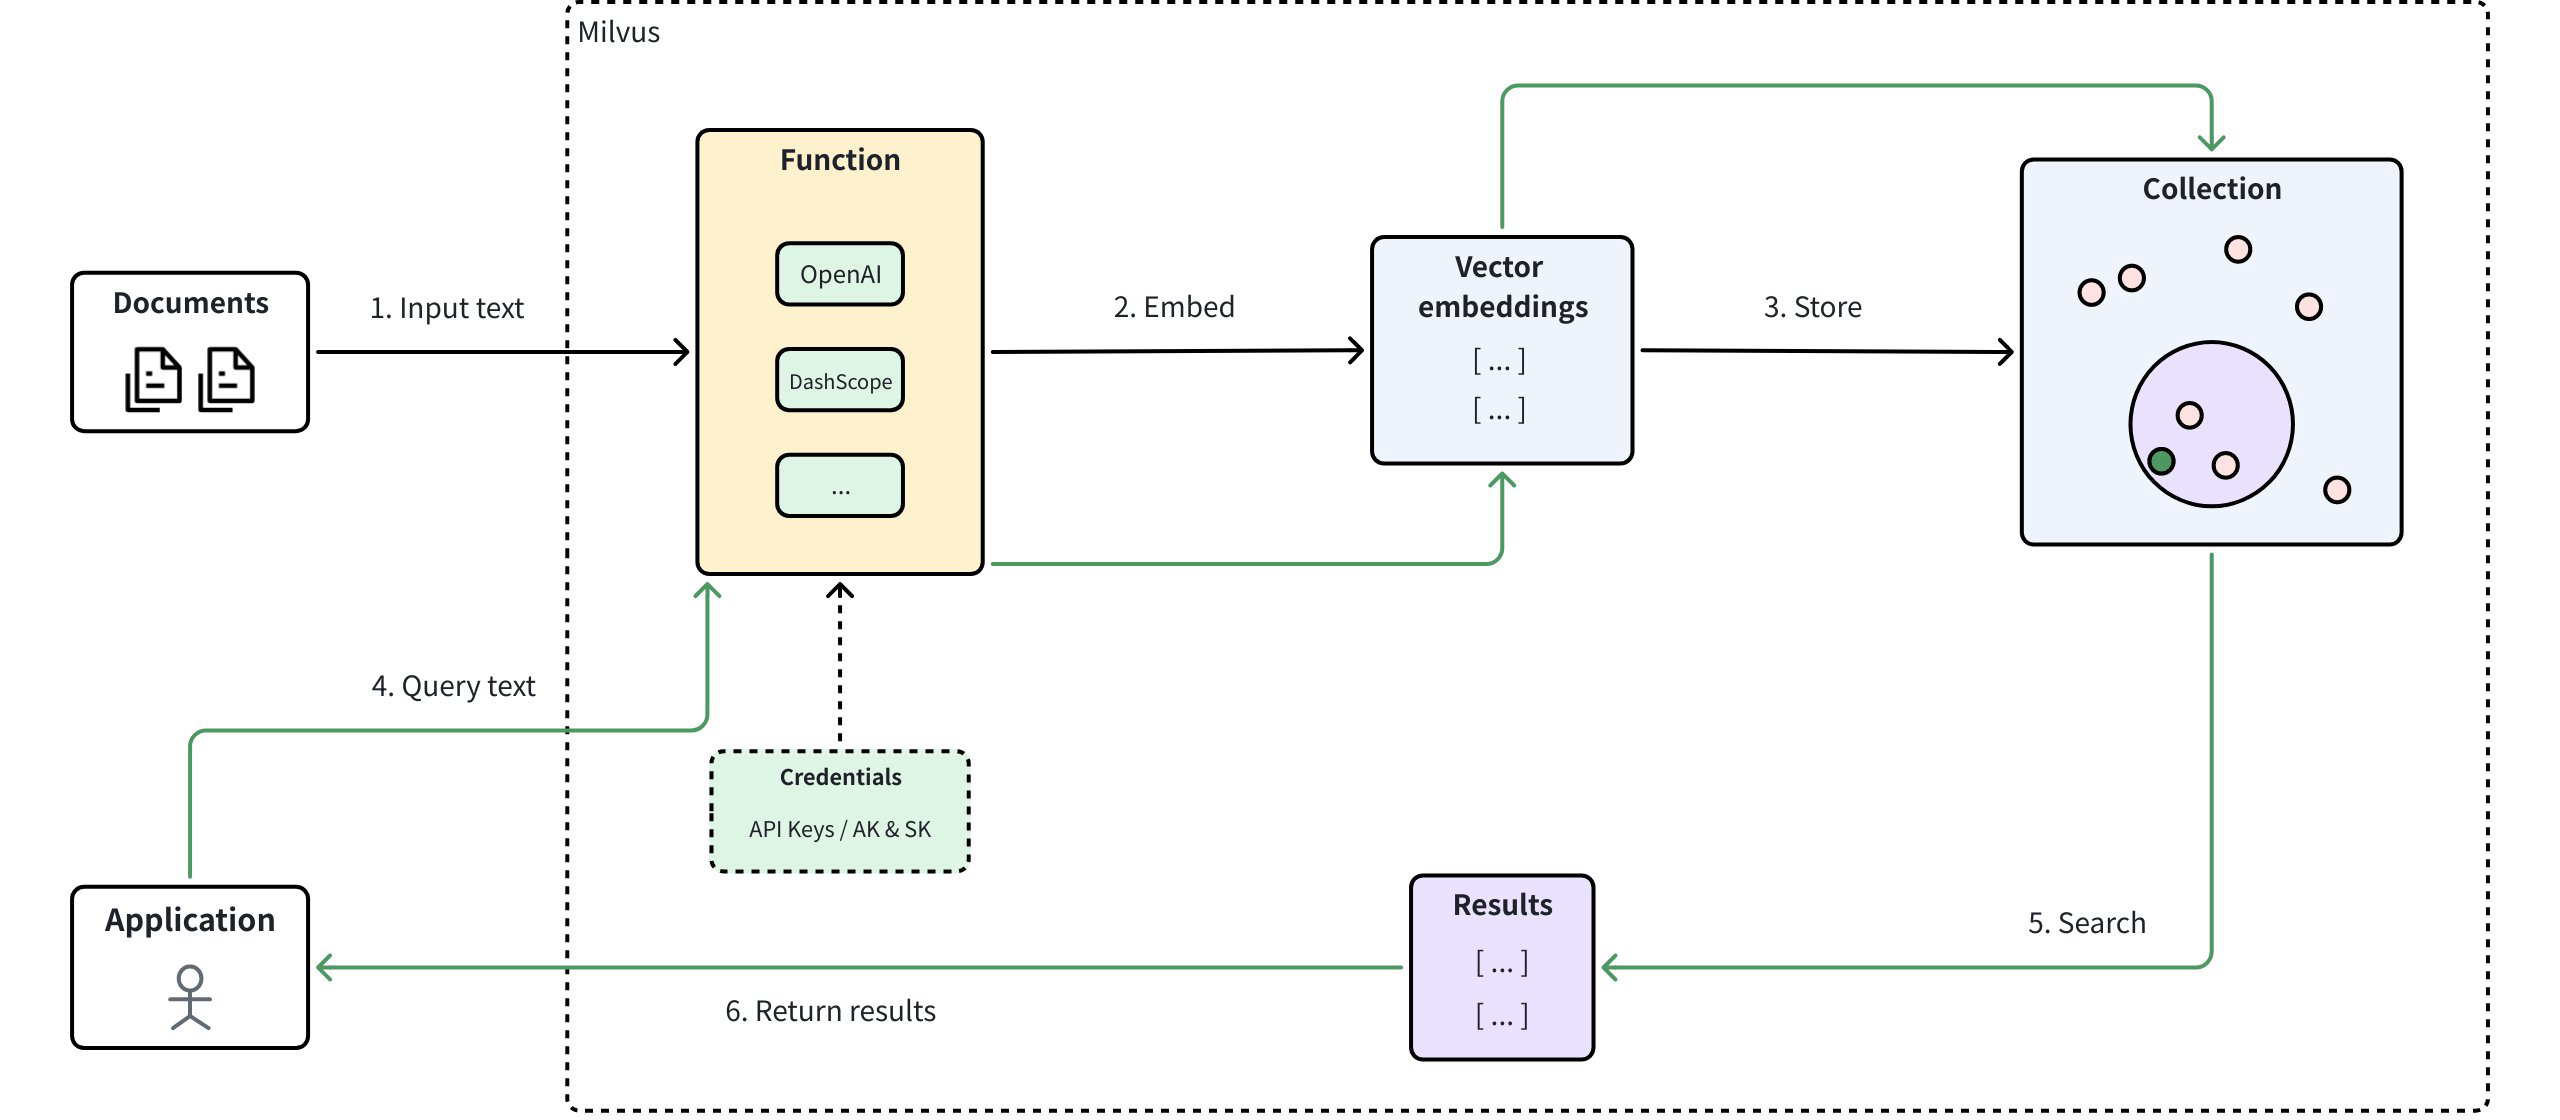 نظرة عامة على وظيفة التضمين
تكوين بيانات الاعتماد
قبل استخدام وظيفة التضمين مع Milvus، قم بتكوين بيانات اعتماد خدمة التضمين للوصول إلى Milvus.
يتيح لك Milvus توفير بيانات اعتماد خدمة التضمين بطريقتين:
ملف التكوين (
milvus.yaml):يوضح المثال الوارد في هذا الموضوع الإعداد الموصى به باستخدام
milvus.yaml.متغيرات البيئة:
للحصول على تفاصيل حول تكوين بيانات الاعتماد عبر متغيرات البيئة، راجع وثائق مزود خدمة التضمين (على سبيل المثال، OpenAI أو Azure OpenAI).
يوضح الرسم البياني التالي عملية تكوين بيانات الاعتماد عبر ملف تكوين Milvus (milvus.yaml) ثم استدعاء الدالة داخل Milvus.
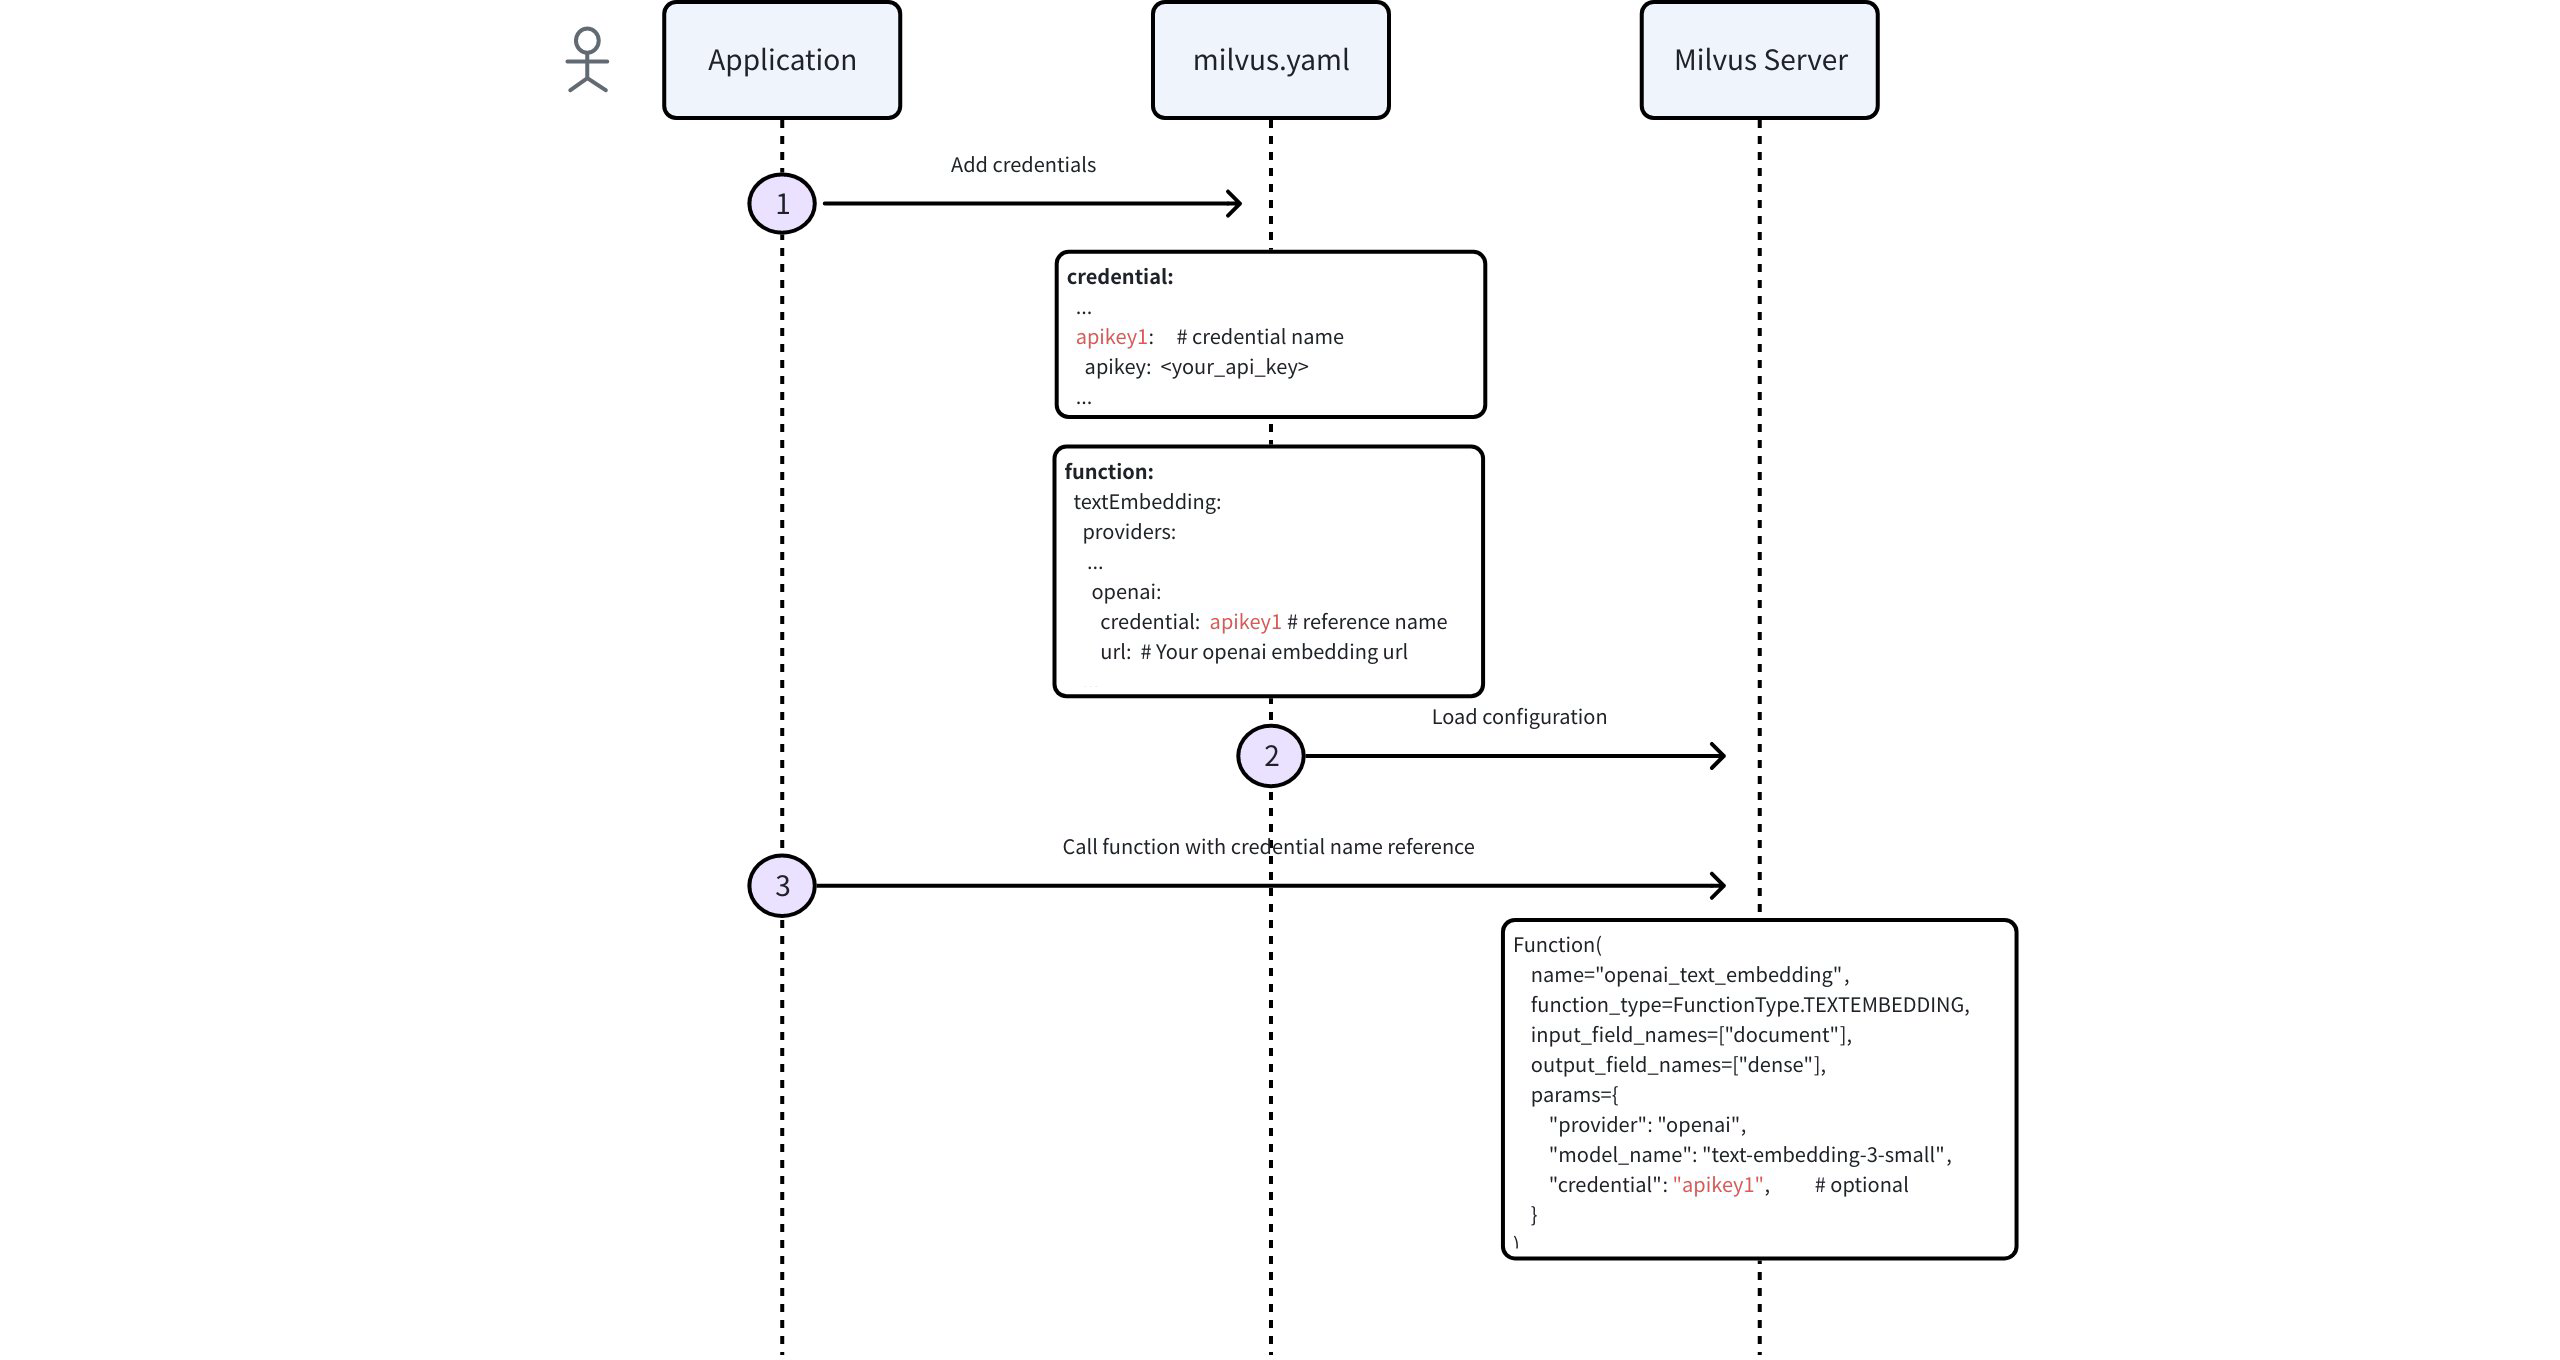 تجاوز تكوين بيانات الاعتماد
الخطوة 1: إضافة بيانات الاعتماد إلى ملف تكوين Milvus
في ملف milvus.yaml الخاص بك، قم بتحرير كتلة credential بإدخال بيانات لكل مزود تحتاج إلى الوصول إليه:
# milvus.yaml credential store section
# This section defines all your authentication credentials for external embedding providers
# Each credential gets a unique name (e.g., aksk1, apikey1) that you'll reference elsewhere
credential:
  # For AWS Bedrock or services using access/secret key pairs
  # 'aksk1' is just an example name - you can choose any meaningful identifier
  aksk1:
    access_key_id: <YOUR_AK>
    secret_access_key: <YOUR_SK>

  # For OpenAI, Voyage AI, or other API key-based services
  # 'apikey1' is a custom name you choose to identify this credential
  apikey1:
    apikey: <YOUR_API_KEY>

  # For Google Vertex AI using service account credentials
  # 'gcp1' is an example name for your Google Cloud credentials
  gcp1:
    credential_json: <BASE64_OF_JSON>
الخطوة 2: تكوين إعدادات المزود
في ملف التكوين نفسه (milvus.yaml)، قم بتحرير كتلة function لإخبار Milvus بالمفتاح الذي يجب استخدامه لتضمين استدعاءات الخدمة:
function:
  textEmbedding:
    providers:
      openai:                         # calls OpenAI
        credential: apikey1           # Reference to the credential label
        # url:                        # (optional) custom url

      bedrock:                        # calls AWS Bedrock
        credential: aksk1             # Reference to the credential label
        region: us-east-2

      vertexai:                       # calls Google Vertex AI
        credential: gcp1              # Reference to the credential label
        # url:                        # (optional) custom url

      tei:                            # Built-in Tiny Embedding model
        enable: true                  # Whether to enable TEI model service
لمزيد من المعلومات حول كيفية تطبيق تكوين Milvus، راجع «تكوين Milvus أثناء التشغيل».
استخدام وظيفة التضمين
بمجرد تكوين بيانات الاعتماد في ملف تكوين Milvus الخاص بك، اتبع هذه الخطوات لتعريف وظائف التضمين واستخدامها.
الخطوة 1: تعريف حقول المخطط
لاستخدام دالة التضمين، قم بإنشاء مجموعة بمخطط معين. يجب أن يتضمن هذا المخطط ثلاثة حقول أساسية على الأقل:
الحقل الأساسي الذي يحدد بشكل فريد كل كيان في المجموعة.
حقل قياسي يخزن البيانات الأولية المراد تضمينها.
حقل متجه مخصص لتخزين التضمينات المتجهة التي ستولدها الدالة للحقل القياسي.
يحدد المثال التالي مخططًا يحتوي على حقل قياسي واحد "document" لتخزين البيانات النصية وحقل متجه واحد "dense" لتخزين التضمينات التي ستولدها وحدة «Function». تذكر ضبط بُعد المتجه (dim) ليتوافق مع ناتج نموذج التضمين الذي اخترته.
from pymilvus import MilvusClient, DataType, Function, FunctionType

# Initialize Milvus client
client = MilvusClient(
    uri="http://localhost:19530",
)

# Create a new schema for the collection
schema = client.create_schema()

# Add primary field "id"
schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)

# Add scalar field "document" for storing textual data
schema.add_field("document", DataType.VARCHAR, max_length=9000)

# Add vector field "dense" for storing embeddings.
# IMPORTANT: Set dim to match the exact output dimension of the embedding model.
# For instance, OpenAI's text-embedding-3-small model outputs 1536-dimensional vectors.
# For dense vector, data type can be FLOAT_VECTOR or INT8_VECTOR
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=1536)
// java
// nodejs
// go
# restful
الخطوة 2: إضافة وظيفة التضمين إلى المخطط
تقوم وحدة Function في Milvus تلقائيًا بتحويل البيانات الأولية المخزنة في حقل قياسي إلى تضمينات وتخزينها في الحقل المتجه المحدد صراحةً.
يضيف المثال أدناه وحدة «Function» (openai_embedding) التي تحول الحقل القياسي "document" إلى تضمينات، وتخزن المتجهات الناتجة في حقل المتجهات "dense" المحدد مسبقًا.
# Define embedding function (example: OpenAI provider)
text_embedding_function = Function(
    name="openai_embedding",                  # Unique identifier for this embedding function
    function_type=FunctionType.TEXTEMBEDDING, # Type of embedding function
    input_field_names=["document"],           # Scalar field to embed
    output_field_names=["dense"],             # Vector field to store embeddings
    params={                                  # Provider-specific configuration (highest priority)
        "provider": "openai",                 # Embedding model provider
        "model_name": "text-embedding-3-small",     # Embedding model
        # "credential": "apikey1",            # Optional: Credential label
        # Optional parameters:
        # "dim": "1536",       # Optionally shorten the vector dimension
        # "user": "user123"    # Optional: identifier for API tracking
    }
)

# Add the embedding function to your schema
schema.add_function(text_embedding_function)
// java
// nodejs
// go
# restful
المعلمة |
الوصف |
قيمة المثال |
|---|---|---|
|
المعرف الفريد لوظيفة التضمين داخل Milvus. |
|
|
نوع الدالة المستخدمة. لتضمين النص، اضبط القيمة على ملاحظة: يقبل Milvus القيمتين |
|
|
حقل عددي يحتوي على البيانات الأولية المراد تضمينها. حاليًا، لا تقبل هذه المعلمة سوى اسم حقل واحد. |
|
|
حقل متجه لتخزين عمليات التضمين التي تم إنشاؤها. حاليًا، لا تقبل هذه المعلمة سوى اسم حقل واحد. |
|
|
قاموس يحتوي على تكوينات التضمين. ملاحظة: تختلف المعلمات الموجودة ضمن " |
|
|
مزود نموذج التضمين. |
|
|
يحدد نموذج التضمين المطلوب استخدامه. |
|
|
تسمية بيانات الاعتماد المحددة في قسم المستوى الأعلى لـ
|
|
|
عدد أبعاد التضمينات الناتجة. بالنسبة لنماذج الجيل الثالث من OpenAI، يمكنك تقصير المتجه الكامل لتقليل التكلفة وزمن الاستجابة دون فقدان كبير للمعلومات الدلالية. لمزيد من المعلومات، راجع منشور مدونة إعلان OpenAI. ملاحظة: إذا قمت بتقصير بُعد المتجه، فتأكد من أن قيمة « |
|
|
معرف على مستوى المستخدم لتتبع استخدام واجهة برمجة التطبيقات (API). |
|
بالنسبة للمجموعات التي تحتوي على حقول عددية متعددة تتطلب تحويل النص إلى متجه، أضف دوال منفصلة إلى مخطط المجموعة، مع التأكد من أن كل دالة لها اسم فريد وقيمة output_field_names.
الخطوة 3: تكوين الفهرس
بعد تعريف المخطط بالحقول الضرورية والدالة المدمجة، قم بإعداد الفهرس لمجموعتك. لتبسيط هذه العملية، استخدم AUTOINDEX كـ index_type ، وهو خيار يسمح لـ Milvus باختيار وتكوين نوع الفهرس الأنسب بناءً على بنية بياناتك.
# Prepare index parameters
index_params = client.prepare_index_params()

# Add AUTOINDEX to automatically select optimal indexing method
index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
// java
// nodejs
// go
# restful
الخطوة 4: إنشاء المجموعة
الآن قم بإنشاء المجموعة باستخدام معلمات المخطط والفهرس المحددة.
# Create collection named "demo"
client.create_collection(
    collection_name='demo',
    schema=schema,
    index_params=index_params
)
// java
// nodejs
// go
# restful
الخطوة 5: إدراج البيانات
بعد إعداد المجموعة والفهرس، تكون جاهزًا لإدراج البيانات الأولية. في هذه العملية، ما عليك سوى توفير النص الأولي. تقوم وحدة الوظائف التي حددناها سابقًا تلقائيًا بإنشاء المتجه المتفرق المقابل لكل إدخال نصي.
# Insert sample documents
client.insert('demo', [
    {'id': 1, 'document': 'Milvus simplifies semantic search through embeddings.'},
    {'id': 2, 'document': 'Vector embeddings convert text into searchable numeric data.'},
    {'id': 3, 'document': 'Semantic search helps users find relevant information quickly.'},
])
// java
// nodejs
// go
# restful
الخطوة 6: إجراء البحث المتجهي
بعد إدخال البيانات، قم بإجراء بحث دلالي باستخدام نص الاستعلام الخام. يقوم Milvus تلقائيًا بتحويل استعلامك إلى متجه تضمين، واسترجاع المستندات ذات الصلة بناءً على التشابه، وإرجاع النتائج الأكثر مطابقة.
# Perform semantic search
results = client.search(
    collection_name='demo',
    data=['How does Milvus handle semantic search?'], # Use text query rather than query vector
    anns_field='dense',   # Use the vector field that stores embeddings
    limit=1,
    output_fields=['document'],
)

print(results)

# Example output:
# data: ["[{'id': 1, 'distance': 0.8821347951889038, 'entity': {'document': 'Milvus simplifies semantic search through embeddings.'}}]"]
// java
// nodejs
// go
# restful
لمزيد من المعلومات حول عمليات البحث والاستعلام، راجع «البحث والاستعلام الأساسي بالمتجهات ».
الأسئلة الشائعة
ما الفرق بين تكوين بيانات الاعتماد في ملف milvus.yaml ومتغيرات البيئة؟
تعمل كلتا الطريقتين، ولكن يُنصح باستخدام ملف تعريف الهوية ( milvus.yaml ) لأنه يوفر إدارة مركزية لبيانات الاعتماد وتسمية متسقة لبيانات الاعتماد عبر جميع مزودي الخدمة. عند استخدام متغيرات البيئة، تختلف أسماء المتغيرات اعتمادًا على مزود خدمة التضمين، لذا يرجى الرجوع إلى الصفحة المخصصة لكل مزود لفهم أسماء متغيرات البيئة المحددة المطلوبة (على سبيل المثال، OpenAI أو Azure OpenAI).
ماذا يحدث إذا لم أحدد معلمة بيانات الاعتماد في تعريف الدالة؟
يتبع Milvus ترتيب تحديد بيانات الاعتماد التالي:
- أولاً، يبحث عن بيانات الاعتماد الافتراضية المُعدة لذلك المزود في ملف
milvus.yaml - إذا لم تكن هناك بيانات اعتماد افتراضية في ملف milvus.yaml، فإنه يلجأ إلى متغيرات البيئة (إذا تم تكوينها)
- إذا لم يتم تكوين بيانات اعتماد
milvus.yamlولا متغيرات البيئة، فسيصدر Milvus خطأً
كيف يمكنني التحقق من أن عمليات التضمين يتم إنشاؤها بشكل صحيح؟
يمكنك التحقق من ذلك عن طريق:
- الاستعلام عن مجموعتك بعد الإدراج لمعرفة ما إذا كان حقل المتجهات يحتوي على بيانات
- التحقق من أن طول حقل المتجهات يتطابق مع الأبعاد المتوقعة
- إجراء بحث بسيط عن التشابه للتحقق من أن التضمينات تنتج نتائج ذات مغزى
عند إجراء بحث عن التشابه، هل يمكنني استخدام متجه استعلام بدلاً من النص الخام؟
نعم، يمكنك استخدام متجهات الاستعلام المحسوبة مسبقًا بدلاً من النص الخام لإجراء بحث التشابه. في حين أن وحدة الوظيفة (Function module) تقوم تلقائيًا بتحويل استعلامات النص الخام إلى تضمينات، يمكنك أيضًا توفير بيانات متجهة مباشرةً إلى المعلمة " data " في عملية البحث الخاصة بك. ملاحظة: يجب أن يكون حجم أبعاد متجه الاستعلام الذي قدمته متسقًا مع حجم أبعاد التضمينات المتجهة التي أنشأتها وحدة الوظائف الخاصة بك.
مثال:
# Using raw text (Function module converts automatically)
results = client.search(
    collection_name='demo',
    data=['How does Milvus handle semantic search?'],
    anns_field='dense',
    limit=1
)

# Using pre-computed query vector (must match stored vector dimensions)
query_vector = [0.1, 0.2, 0.3, ...]  # Must be same dimension as stored embeddings
results = client.search(
    collection_name='demo',
    data=[query_vector],
    anns_field='dense',
    limit=1
)
// java
// nodejs
// go
# restful
